Overfitting: quando sua IA aprende bem demais… e perde o essencial
Descubra como o sobreajuste impede os modelos de IA de generalizarem bem e as técnicas simples para evitá-lo.
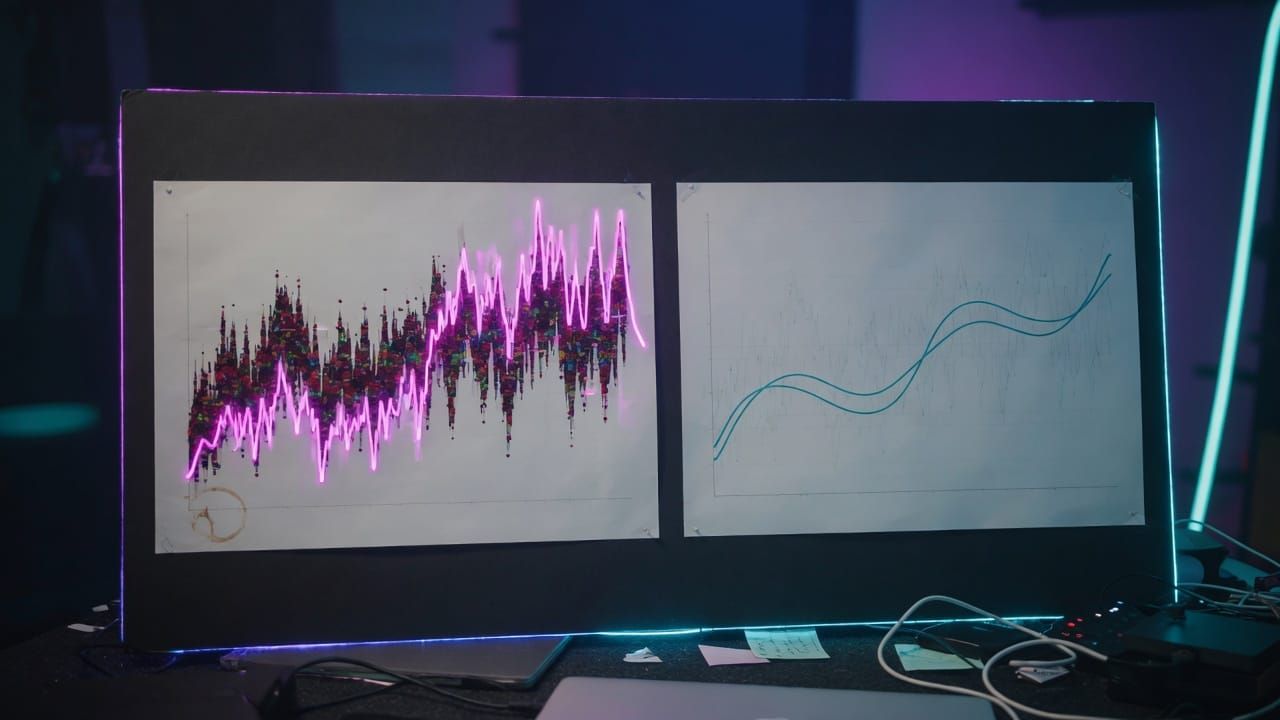
Imagine um aluno que memoriza de cor todas as respostas de um manual sem compreender os conceitos: ele acertará perfeitamente os exercícios já vistos, mas falhará diante de uma questão nova. É exatamente isso que acontece com o sobreajuste em inteligência artificial. Esse fenômeno, também chamado de overfitting, é uma das armadilhas mais comuns ao treinar um modelo. Por isso, é essencial compreendê-lo para construir sistemas realmente eficientes.
O que é o sobreajuste?
O sobreajuste ocorre quando um modelo aprende não apenas as tendências gerais dos dados de treinamento, mas também o ruído e os detalhes específicos desse conjunto. Resultado: ele obtém excelentes desempenhos nos dados de treinamento, mas ruins em dados nunca vistos. A generalização, ou seja, a capacidade de funcionar bem em novos dados, sofre diretamente com isso.
Por que isso acontece?
Vários fatores favorecem o overfitting:
- O modelo é complexo demais em relação à quantidade de dados (parâmetros demais).
- Os dados de treinamento contêm ruído ou anomalias.
- O treinamento dura tempo demais sem controle.
- O conjunto de dados é pequeno demais ou pouco diversificado.
Essas situações levam o modelo a “memorizar” em vez de “compreender”.
Como identificar o sobreajuste?
O sinal mais claro é uma diferença significativa entre o desempenho no conjunto de treinamento e no conjunto de validação ou de teste. Se a precisão de treinamento atinge 98% enquanto a de validação estagna em 75%, há grandes chances de que o modelo esteja sobreajustando. As curvas de aprendizado também permitem visualizar esse fenômeno: a curva de treinamento continua a descer enquanto a de validação sobe ou estagna.
Como combater o overfitting?
Felizmente, existem várias técnicas eficazes:
- Aumentar a quantidade e a diversidade dos dados.
- Simplificar o modelo (reduzir o número de camadas ou de neurônios).
- Usar a regularização (L1, L2) que penaliza os pesos excessivamente grandes.
- Aplicar o dropout nas redes neurais.
- Parar o treinamento assim que as performances de validação deixarem de melhorar (early stopping).
- Usar a validação cruzada para avaliar melhor a robustez do modelo.
Um exemplo simples em Python
Aqui está um trecho ilustrando o uso da validação cruzada e do early stopping com o scikit-learn:
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100)
scores = cross_val_score(model, X, y, cv=5)
print("Score moyen :", scores.mean())
Essa abordagem permite obter uma estimativa mais confiável do desempenho real do modelo em dados desconhecidos.
Ao dominar o overfitting, você construirá modelos de IA capazes de se adaptar a novas situações em vez de simplesmente repetir o que já viram. Essa é a chave para uma inteligência artificial verdadeiramente útil e confiável no mundo real.
💬 Tem alguma dúvida ou quer ir mais fundo? Junte-se à comunidade no Discord: https://discord.gg/GwhUKccQcM