Sobreajuste: cuando tu IA aprende demasiado bien… y se pierde lo esencial
Descubra cómo el sobreajuste impide que los modelos de IA generalicen bien y las técnicas simples para evitarlo.
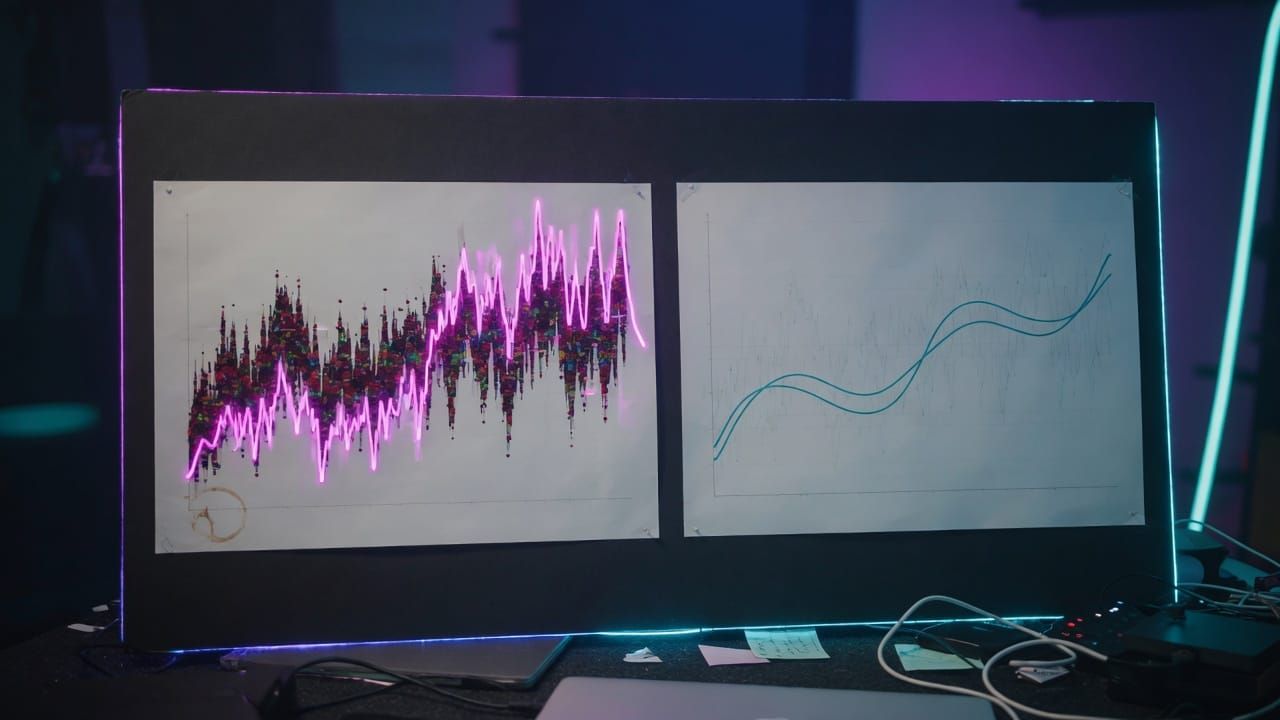
Imagina un alumno que memoriza de memoria todas las respuestas de un manual sin comprender los conceptos: acertará a la perfección los ejercicios ya vistos, pero fallará ante una pregunta nueva. Esto es exactamente lo que sucede con el sobreajuste en inteligencia artificial. Este fenómeno, también llamado overfitting, es uno de los escollos más comunes al entrenar un modelo. Por lo tanto, es esencial comprenderlo para construir sistemas realmente eficientes.
¿Qué es el sobreajuste?
El sobreajuste ocurre cuando un modelo aprende no solo las tendencias generales de los datos de entrenamiento, sino también el ruido y los detalles específicos de ese conjunto. Resultado: obtiene excelentes rendimientos en los datos de entrenamiento, pero malos en datos nunca vistos. La generalización, es decir, la capacidad de funcionar bien en datos nuevos, se ve directamente afectada.
¿Por qué ocurre esto?
Varios factores favorecen el overfitting:
- El modelo es demasiado complejo en relación con la cantidad de datos (demasiados parámetros).
- Los datos de entrenamiento contienen ruido o anomalías.
- El entrenamiento dura demasiado tiempo sin control.
- El conjunto de datos es demasiado pequeño o poco diverso.
Estas situaciones empujan al modelo a «memorizar» en lugar de «comprender».
¿Cómo detectar el sobreajuste?
El signo más claro es una diferencia importante entre los rendimientos en el conjunto de entrenamiento y los del conjunto de validación o de prueba. Si la precisión de entrenamiento alcanza el 98 % mientras que la de validación se estanca en el 75 %, hay muchas probabilidades de que el modelo esté sobreajustando. Las curvas de aprendizaje también permiten visualizar este fenómeno: la curva de entrenamiento continúa descendiendo mientras que la de validación asciende o se estanca.
¿Cómo combatir el overfitting?
Afortunadamente, existen varias técnicas eficaces:
- Aumentar la cantidad y la diversidad de los datos.
- Simplificar el modelo (reducir el número de capas o de neuronas).
- Utilizar la regularización (L1, L2) que penaliza los pesos demasiado importantes.
- Aplicar el dropout en las redes neuronales.
- Detener el entrenamiento en cuanto el rendimiento de validación deje de mejorar (early stopping).
- Utilizar la validación cruzada para evaluar mejor la robustez del modelo.
Un ejemplo simple en Python
Aquí hay un extracto que ilustra el uso de la validación cruzada y del early stopping con scikit-learn:
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100)
scores = cross_val_score(model, X, y, cv=5)
print("Score moyen :", scores.mean())
Este enfoque permite obtener una estimación más fiable del rendimiento real del modelo en datos desconocidos.
Al dominar el sobreajuste, construirás modelos de IA capaces de adaptarse a nuevas situaciones en lugar de simplemente repetir lo que ya han visto. Esta es la clave de una inteligencia artificial realmente útil y fiable en el mundo real.
💬 ¿Tienes alguna pregunta o ganas de profundizar? Únete a la comunidad en Discord: https://discord.gg/GwhUKccQcM