الإفراط في التعلم: عندما يتعلم الذكاء الاصطناعي لديك جيدًا جدًا… ويغفل الأساسي
اكتشف كيف يمنع الإفراط في الملاءمة نماذج الذكاء الاصطناعي من التعميم بشكل جيد والتقنيات البسيطة لتجنبه.
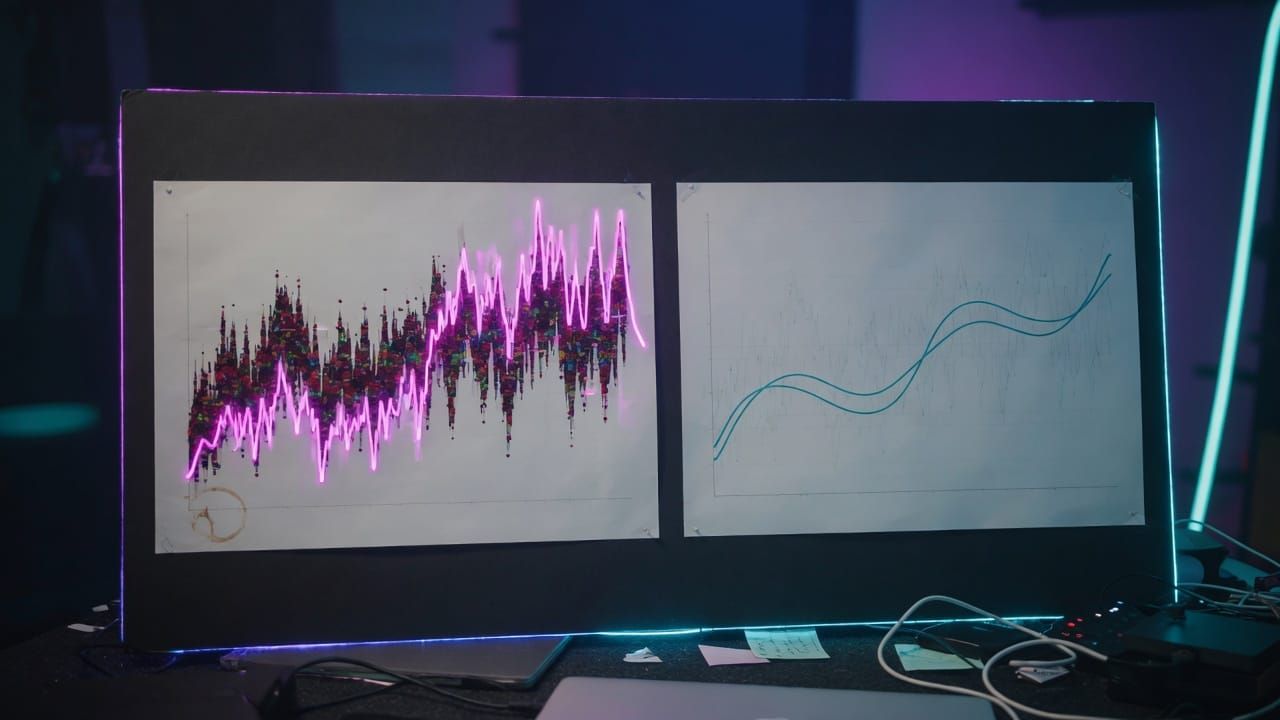
تخيل طالباً يحفظ عن ظهر قلب جميع إجابات كتاب دون فهم المفاهيم: سيحل التمارين التي سبق له رؤيتها بنجاح تام، لكنه سيفشل أمام سؤال جديد. هذا بالضبط ما يحدث مع الإفراط في التعلم في الذكاء الاصطناعي. هذه الظاهرة، التي تُسمى أيضاً overfitting، هي واحدة من أكثر الفخاخ شيوعاً عند تدريب نموذج. لذلك من الضروري فهمها لبناء أنظمة فعالة حقاً.
ما هو الإفراط في التعلم؟
يحدث الإفراط في التعلم عندما يتعلم النموذج ليس فقط الاتجاهات العامة لبيانات التدريب، بل أيضًا الضوضاء والتفاصيل الخاصة بهذه المجموعة. النتيجة: يحقق أداءً ممتازًا على بيانات التدريب، لكنه ضعيف على بيانات لم يسبق له رؤيتها. وتعاني التعميم مباشرة، أي القدرة على الأداء الجيد على بيانات جديدة.
لماذا يحدث ذلك؟
عدة عوامل تساهم في الإفراط في التكيف (overfitting):
- النموذج معقد للغاية مقارنة بكمية البيانات (عدد كبير من المعاملات).
- تحتوي بيانات التدريب على ضوضاء أو حالات شاذة.
- يستمر التدريب لفترة طويلة دون أي تحكم.
- مجموعة البيانات صغيرة جداً أو غير متنوعة بما فيه الكفاية.
تدفع هذه الحالات النموذج إلى « الحفظ » بدلاً من « الفهم ».
كيفية اكتشاف الإفراط في التعلم؟
العلامة الأوضح هي وجود فرق كبير بين الأداء على مجموعة التدريب وتلك على مجموعة التحقق أو الاختبار. إذا وصلت دقة التدريب إلى 98% بينما تظل دقة التحقق عند 75%، فمن المحتمل جدًا أن النموذج يعاني من الإفراط في التعلم. كما تسمح منحنيات التعلم بتصور هذه الظاهرة: يستمر منحنى التدريب في الانخفاض بينما يرتفع منحنى التحقق أو يظل ثابتًا.
كيفية مكافحة الـoverfitting؟
لحسن الحظ، توجد عدة تقنيات فعالة:
- زيادة كمية البيانات وتنوعها.
- تبسيط النموذج (تقليل عدد الطبقات أو الخلايا العصبية).
- استخدام التنظيم (L1، L2) الذي يعاقب الأوزان الكبيرة جداً.
- تطبيق الـdropout في الشبكات العصبية.
- إيقاف التدريب بمجرد توقف أداء التحقق عن التحسن (early stopping).
- استخدام التحقق المتقاطع لتقييم متانة النموذج بشكل أفضل.
مثال بسيط في بايثون
إليك مقتطف يوضح استخدام التحقق المتقاطع والتوقف المبكر مع scikit-learn:
from sklearn.model_selection import cross_val_score
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100)
scores = cross_val_score(model, X, y, cv=5)
print("Score moyen :", scores.mean())
يتيح هذا النهج الحصول على تقدير أكثر موثوقية للأداء الحقيقي للنموذج على بيانات غير معروفة.
من خلال السيطرة على الإفراط في التعلم، ستبني نماذج ذكاء اصطناعي قادرة على التكيف مع مواقف جديدة بدلاً من مجرد تكرار ما سبق أن رأته. وهذا هو مفتاح ذكاء اصطناعي مفيد وموثوق حقاً في العالم الحقيقي.
💬 هل لديك سؤال أو تريد التعمق أكثر؟ انضم إلى المجتمع على ديسكورد: https://discord.gg/GwhUKccQcM