Surapprentissage et généralisation : comment votre IA peut-elle vraiment apprendre ?
Comprenez le surapprentissage, ses causes et les techniques simples pour améliorer la généralisation de vos modèles d'IA.
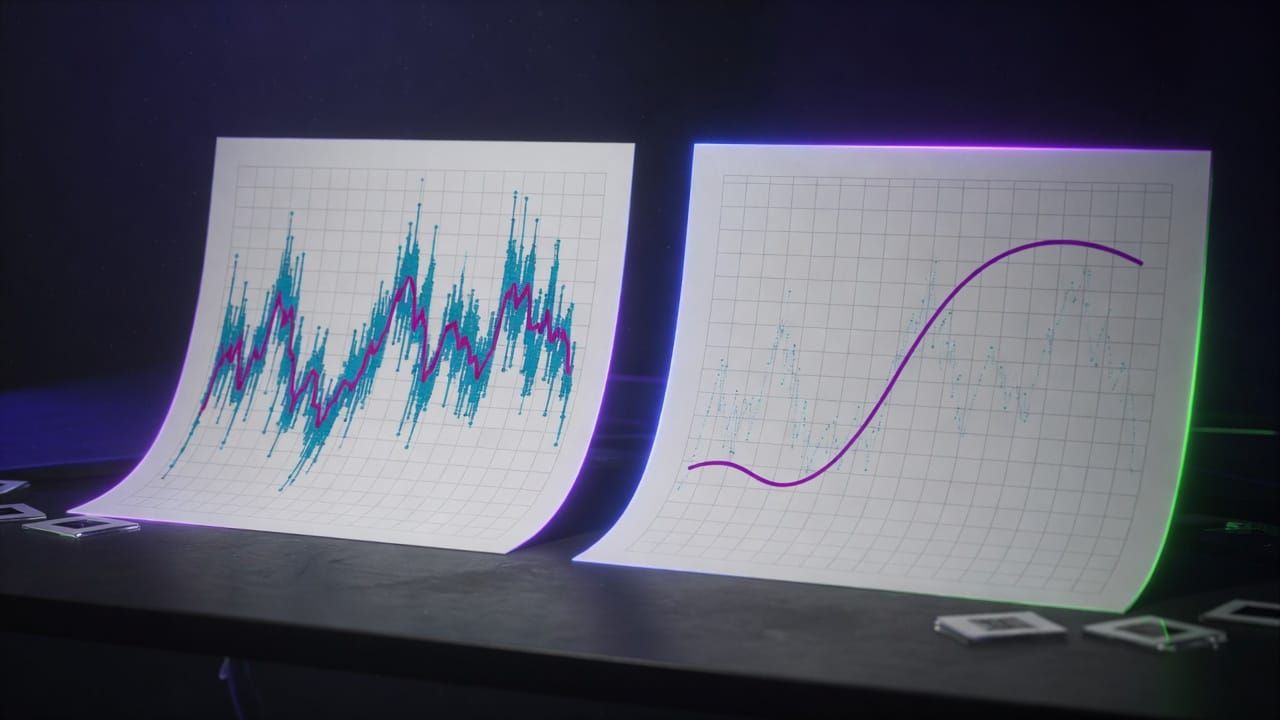
Imaginez un élève qui mémorise par cœur toutes les réponses d’un manuel sans comprendre les concepts : il réussira parfaitement les exercices déjà vus, mais échouera face à des questions nouvelles. C’est exactement ce qui se passe avec le surapprentissage en intelligence artificielle. Ce phénomène, aussi appelé overfitting, empêche les modèles d’être vraiment utiles dans la vie réelle. Découvrons ensemble comment le détecter et le corriger pour que vos algorithmes généralisent correctement.
Qu’est-ce que le surapprentissage ?
Le surapprentissage survient lorsqu’un modèle d’apprentissage automatique s’adapte trop précisément aux données d’entraînement, y compris au bruit et aux exceptions. Au lieu d’apprendre les patterns généraux, il mémorise les exemples spécifiques. Résultat : il obtient d’excellentes performances sur les données vues pendant l’entraînement, mais de mauvaises sur de nouvelles données.
- Le modèle devient trop complexe par rapport à la quantité de données.
- Il capture le bruit statistique plutôt que les tendances réelles.
- Les performances chutent brutalement sur des données inédites.
Pourquoi le surapprentissage se produit-il ?
Plusieurs facteurs favorisent ce problème. Un modèle trop puissant (beaucoup de paramètres) face à peu de données tend à surapprendre. De même, un entraînement trop long permet au modèle d’ajuster ses poids aux moindres détails. Enfin, des données d’entraînement non représentatives ou bruitées aggravent la situation.
- Modèle trop complexe (ex. : un réseau de neurones très profond).
- Jeu de données trop petit ou peu varié.
- Absence de techniques de régularisation.
La généralisation : l’objectif principal
La généralisation désigne la capacité d’un modèle à bien performer sur des données qu’il n’a jamais vues. C’est le vrai critère de succès en IA. Un modèle qui généralise bien a appris les règles sous-jacentes plutôt que les exemples eux-mêmes. Pour mesurer cette capacité, on utilise systématiquement un jeu de test séparé des données d’entraînement.
Comment détecter le surapprentissage ?
La méthode la plus simple consiste à comparer les performances sur les données d’entraînement et sur un jeu de validation. Si l’erreur d’entraînement diminue continuellement tandis que l’erreur de validation augmente, c’est le signe classique du surapprentissage. On peut aussi visualiser les courbes d’apprentissage pour repérer ce décalage.
Techniques efficaces pour améliorer la généralisation
Heureusement, de nombreuses solutions existent. La validation croisée, le dropout dans les réseaux de neurones, la régularisation L1/L2 ou encore l’augmentation de données permettent de limiter le surapprentissage. Réduire la complexité du modèle ou collecter plus de données reste également très efficace.
- Utiliser la validation croisée pour évaluer la robustesse.
- Appliquer du dropout ou de la régularisation.
- Augmenter les données ou simplifier le modèle.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
En appliquant ces bonnes pratiques, vous aiderez vos modèles à passer du stade « perroquet » à celui d’apprenant véritablement intelligent.
💬 Une question ou envie d'aller plus loin ? Rejoins la communauté sur Discord : https://discord.gg/GwhUKccQcM