Sobreajuste e generalização: como sua IA pode realmente aprender?
Entenda o sobreajuste, suas causas e as técnicas simples para melhorar a generalização dos seus modelos de IA.
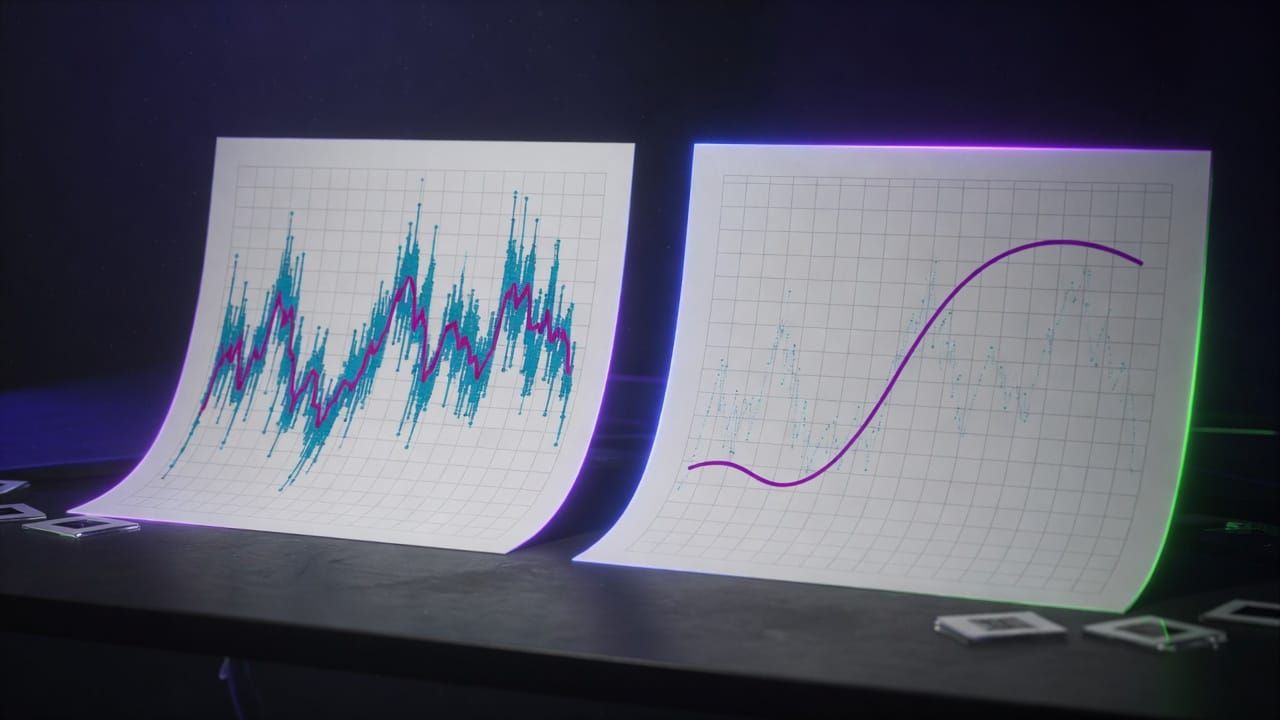
Imagine um aluno que memoriza de cor todas as respostas de um manual sem compreender os conceitos: ele acertará perfeitamente os exercícios já vistos, mas falhará diante de perguntas novas. É exatamente isso que acontece com o sobreajuste em inteligência artificial. Esse fenômeno, também chamado de overfitting, impede que os modelos sejam realmente úteis na vida real. Vamos descobrir juntos como detectá-lo e corrigi-lo para que seus algoritmos generalizem corretamente.
O que é o sobreajuste?
O sobreajuste ocorre quando um modelo de aprendizado de máquina se adapta excessivamente aos dados de treinamento, incluindo ruídos e exceções. Em vez de aprender os padrões gerais, ele memoriza os exemplos específicos. Resultado: obtém um excelente desempenho nos dados vistos durante o treinamento, mas um desempenho ruim em novos dados.
- O modelo se torna muito complexo em relação à quantidade de dados.
- Ele captura o ruído estatístico em vez das tendências reais.
- O desempenho cai drasticamente em dados inéditos.
Por que o sobreajuste ocorre?
Vários fatores favorecem esse problema. Um modelo muito poderoso (muitos parâmetros) diante de poucos dados tende a sobreajustar. Da mesma forma, um treinamento muito longo permite que o modelo ajuste seus pesos aos mínimos detalhes. Finalmente, dados de treinamento não representativos ou ruidosos agravam a situação.
- Modelo muito complexo (ex.: uma rede neural muito profunda).
- Conjunto de dados muito pequeno ou pouco variado.
- Ausência de técnicas de regularização.
A generalização: o objetivo principal
A generalização designa a capacidade de um modelo de ter um bom desempenho em dados que ele nunca viu. Esse é o verdadeiro critério de sucesso em IA. Um modelo que generaliza bem aprendeu as regras subjacentes em vez dos próprios exemplos. Para medir essa capacidade, utiliza-se sistematicamente um conjunto de teste separado dos dados de treinamento.
Como detectar o overfitting?
O método mais simples consiste em comparar o desempenho nos dados de treinamento e em um conjunto de validação. Se o erro de treinamento diminui continuamente enquanto o erro de validação aumenta, esse é o sinal clássico de overfitting. Também é possível visualizar as curvas de aprendizado para identificar esse desvio.
Técnicas eficazes para melhorar a generalização
Felizmente, existem muitas soluções. A validação cruzada, o dropout em redes neurais, a regularização L1/L2 ou o aumento de dados permitem limitar o overfitting. Reduzir a complexidade do modelo ou coletar mais dados também continua sendo muito eficaz.
- Usar a validação cruzada para avaliar a robustez.
- Aplicar dropout ou regularização.
- Aumentar os dados ou simplificar o modelo.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
Ao aplicar essas boas práticas, você ajudará seus modelos a passar do estágio de « papagaio » para o de aprendiz verdadeiramente inteligente.
💬 Uma pergunta ou quer ir mais longe? Junte-se à comunidade no Discord: https://discord.gg/GwhUKccQcM