Sobreajuste y generalización: ¿cómo puede tu IA aprender de verdad?
Comprenda el sobreajuste, sus causas y las técnicas simples para mejorar la generalización de sus modelos de IA.
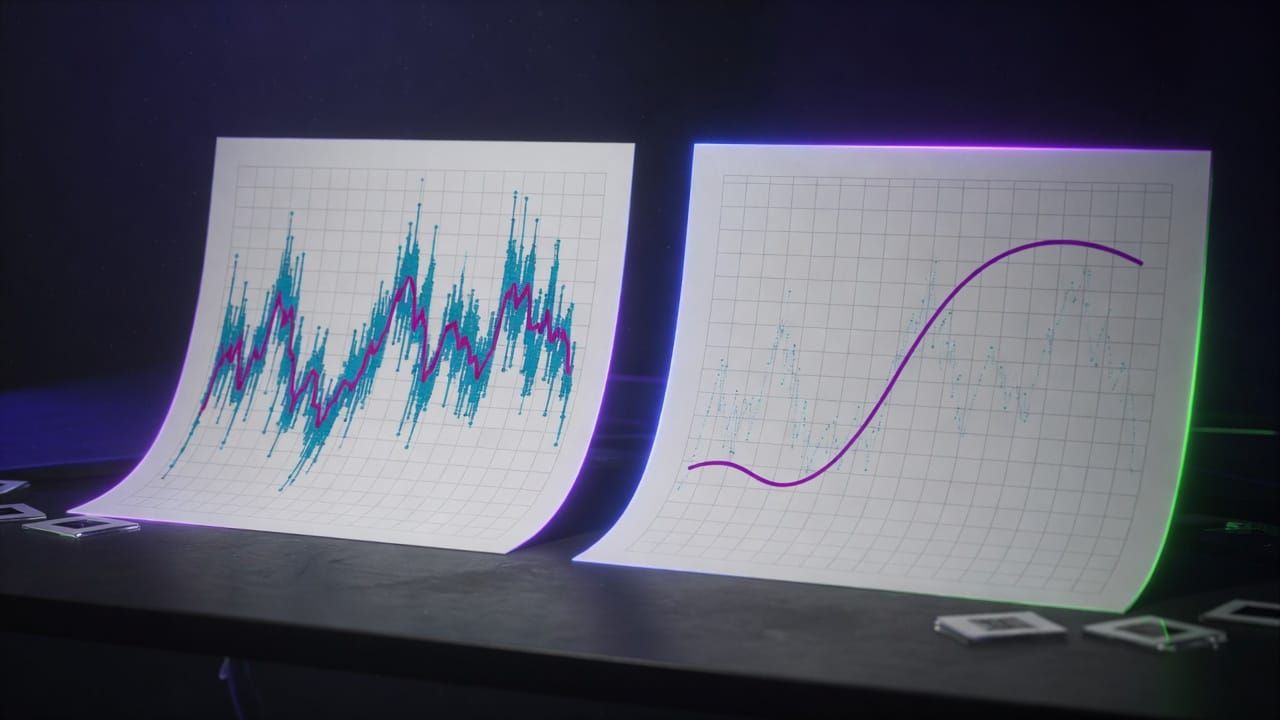
Imagine un alumno que memoriza de memoria todas las respuestas de un manual sin comprender los conceptos: resolverá perfectamente los ejercicios ya vistos, pero fallará ante preguntas nuevas. Esto es exactamente lo que sucede con el sobreajuste en inteligencia artificial. Este fenómeno, también llamado overfitting, impide que los modelos sean realmente útiles en la vida real. Descubramos juntos cómo detectarlo y corregirlo para que sus algoritmos generalicen correctamente.
¿Qué es el sobreajuste?
El sobreajuste ocurre cuando un modelo de aprendizaje automático se adapta demasiado precisamente a los datos de entrenamiento, incluyendo el ruido y las excepciones. En lugar de aprender los patrones generales, memoriza los ejemplos específicos. Resultado: obtiene excelentes rendimientos en los datos vistos durante el entrenamiento, pero malos en datos nuevos.
- El modelo se vuelve demasiado complejo en relación con la cantidad de datos.
- Captura el ruido estadístico en lugar de las tendencias reales.
- Los rendimientos caen drásticamente en datos inéditos.
¿Por qué se produce el sobreajuste?
Varios factores favorecen este problema. Un modelo demasiado potente (con muchos parámetros) ante pocos datos tiende a sobreajustarse. Asimismo, un entrenamiento excesivamente largo permite que el modelo ajuste sus pesos a los detalles más mínimos. Por último, los datos de entrenamiento no representativos o con ruido agravan la situación.
- Modelo demasiado complejo (p. ej.: una red neuronal muy profunda).
- Conjunto de datos demasiado pequeño o poco variado.
- Ausencia de técnicas de regularización.
La generalización: el objetivo principal
La generalización designa la capacidad de un modelo para rendir bien en datos que nunca ha visto. Es el verdadero criterio de éxito en IA. Un modelo que generaliza bien ha aprendido las reglas subyacentes en lugar de los ejemplos mismos. Para medir esta capacidad, se utiliza sistemáticamente un conjunto de prueba separado de los datos de entrenamiento.
¿Cómo detectar el sobreajuste?
El método más sencillo consiste en comparar el rendimiento en los datos de entrenamiento y en un conjunto de validación. Si el error de entrenamiento disminuye continuamente mientras que el error de validación aumenta, es el signo clásico del sobreajuste. También podemos visualizar las curvas de aprendizaje para detectar este desfase.
Técnicas eficaces para mejorar la generalización
Afortunadamente, existen numerosas soluciones. La validación cruzada, el dropout en las redes neuronales, la regularización L1/L2 o incluso el aumento de datos permiten limitar el sobreajuste. Reducir la complejidad del modelo o recopilar más datos también sigue siendo muy efectivo.
- Usar la validación cruzada para evaluar la robustez.
- Aplicar dropout o regularización.
- Aumentar los datos o simplificar el modelo.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
Al aplicar estas buenas prácticas, ayudarás a tus modelos a pasar de la etapa de « loro » a la de un aprendiz verdaderamente inteligente.
💬 ¿Una pregunta o ganas de ir más lejos? Únete a la comunidad en Discord : https://discord.gg/GwhUKccQcM