الإفراط في الملاءمة والتعميم: كيف يمكن لذكائك الاصطناعي أن يتعلم حقًا؟
فهم الإفراط في التعلم، أسبابه، والتقنيات البسيطة لتحسين تعميم نماذج الذكاء الاصطناعي الخاصة بك.
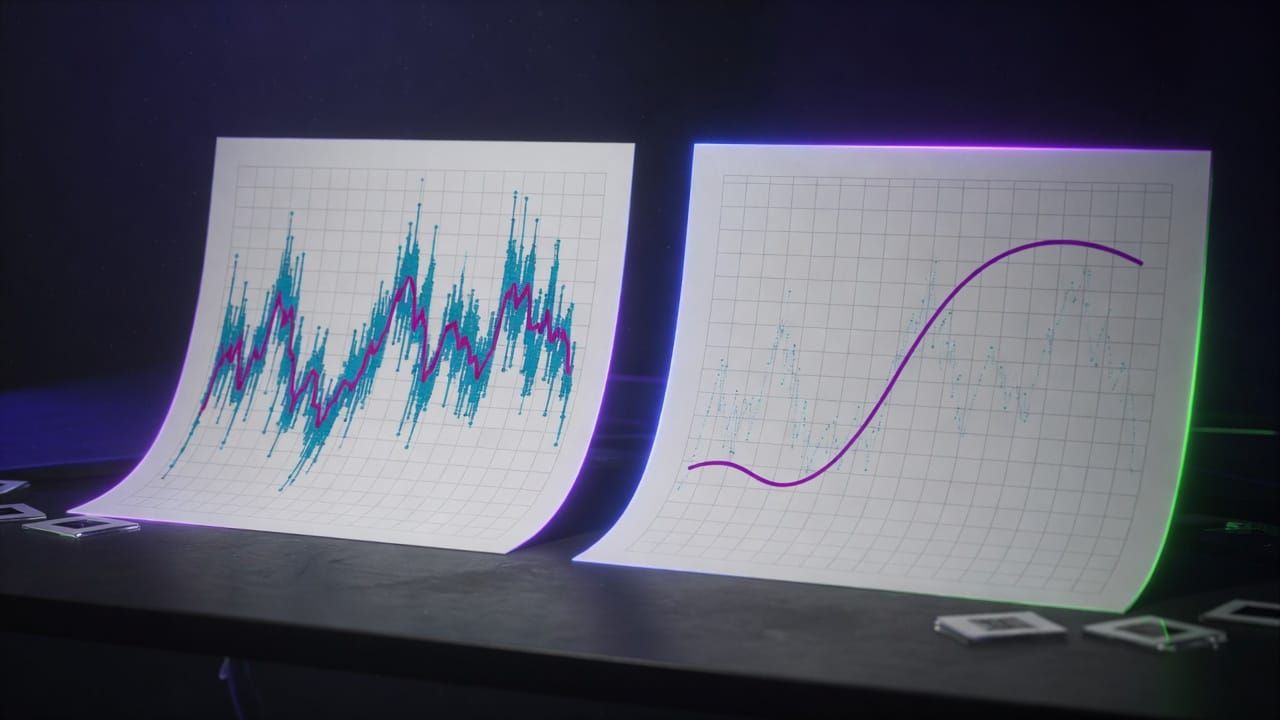
تخيّل طالباً يحفظ جميع إجابات كتابه المدرسي عن ظهر قلب دون فهم المفاهيم: سيؤدي التمارين التي سبق له رؤيتها بشكل مثالي، لكنه سيفشل عند مواجهة أسئلة جديدة. هذا تماماً ما يحدث مع الإفراط في التعلم في الذكاء الاصطناعي. هذه الظاهرة، المعروفة أيضاً باسم overfitting، تمنع النماذج من أن تكون مفيدة حقاً في الحياة الواقعية. دعونا نستكشف معاً كيفية اكتشافها وتصحيحها لتتمكن خوارزمياتكم من التعميم بشكل صحيح.
ما هو الإفراط في الملاءمة؟
يحدث الإفراط في الملاءمة عندما يتكيف نموذج التعلم الآلي بدقة زائدة مع بيانات التدريب، بما في ذلك الضوضاء والاستثناءات. بدلاً من تعلم الأنماط العامة، يحفظ الأمثلة المحددة. النتيجة: يحقق أداءً ممتازًا على البيانات التي شاهدها أثناء التدريب، لكنه ضعيف على البيانات الجديدة.
- يصبح النموذج معقدًا جدًا مقارنة بكمية البيانات.
- يلتقط الضوضاء الإحصائية بدلاً من الاتجاهات الحقيقية.
- تنخفض الأداءات بشكل حاد على بيانات جديدة.
لماذا يحدث الإفراط في التعلم؟
تساهم عدة عوامل في حدوث هذه المشكلة. يميل نموذج قوي جداً (يحتوي على الكثير من المعلمات) مع بيانات قليلة إلى الإفراط في التعلم. وبالمثل، يسمح التدريب الطويل جداً للنموذج بتعديل أوزانه لأدق التفاصيل. وأخيراً، تؤدي بيانات التدريب غير التمثيلية أو المليئة بالضوضاء إلى تفاقم الوضع.
- نموذج معقد جداً (مثال: شبكة عصبية عميقة جداً).
- مجموعة بيانات صغيرة جداً أو غير متنوعة بما يكفي.
- غياب تقنيات التنظيم.
التعميم: الهدف الرئيسي
يشير التعميم إلى قدرة النموذج على الأداء الجيد على بيانات لم يسبق له رؤيتها. وهذا هو المعيار الحقيقي للنجاح في الذكاء الاصطناعي. النموذج الذي يعمم جيدًا يكون قد تعلم القواعد الكامنة بدلاً من الأمثلة نفسها. ولقياس هذه القدرة، يُستخدم دائمًا مجموعة اختبار منفصلة عن بيانات التدريب.
كيفية اكتشاف الإفراط في التعلم؟
تتمثل الطريقة الأبسط في مقارنة الأداء على بيانات التدريب وعلى مجموعة التحقق. فإذا انخفض خطأ التدريب باستمرار بينما يرتفع خطأ التحقق، فهذا يُعد العلامة الكلاسيكية للإفراط في التعلم. كما يمكن تصور منحنيات التعلم لرصد هذا الاختلاف.
تقنيات فعالة لتحسين التعميم
لحسن الحظ، توجد العديد من الحلول. يساعد التحقق المتقاطع، والتسرب في الشبكات العصبية، والتنظيم L1/L2، أو زيادة البيانات في الحد من الإفراط في التعلم. كما أن تقليل تعقيد النموذج أو جمع المزيد من البيانات يظل فعالاً للغاية.
- استخدم التحقق المتقاطع لتقييم المتانة.
- تطبيق التسرب أو التنظيم.
- زيادة البيانات أو تبسيط النموذج.
from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
من خلال تطبيق هذه الممارسات الجيدة، ستساعد نماذجك على الانتقال من مرحلة «الببغاء» إلى مرحلة المتعلم الذكي حقًا.
💬 هل لديك سؤال أو تريد التعمق أكثر؟ انضم إلى المجتمع على ديسكورد: https://discord.gg/GwhUKccQcM