Les jeux de données déséquilibrés : comment les gérer efficacement
Guide complet pour comprendre et traiter les datasets déséquilibrés en IA avec métriques, techniques et exemples concrets.
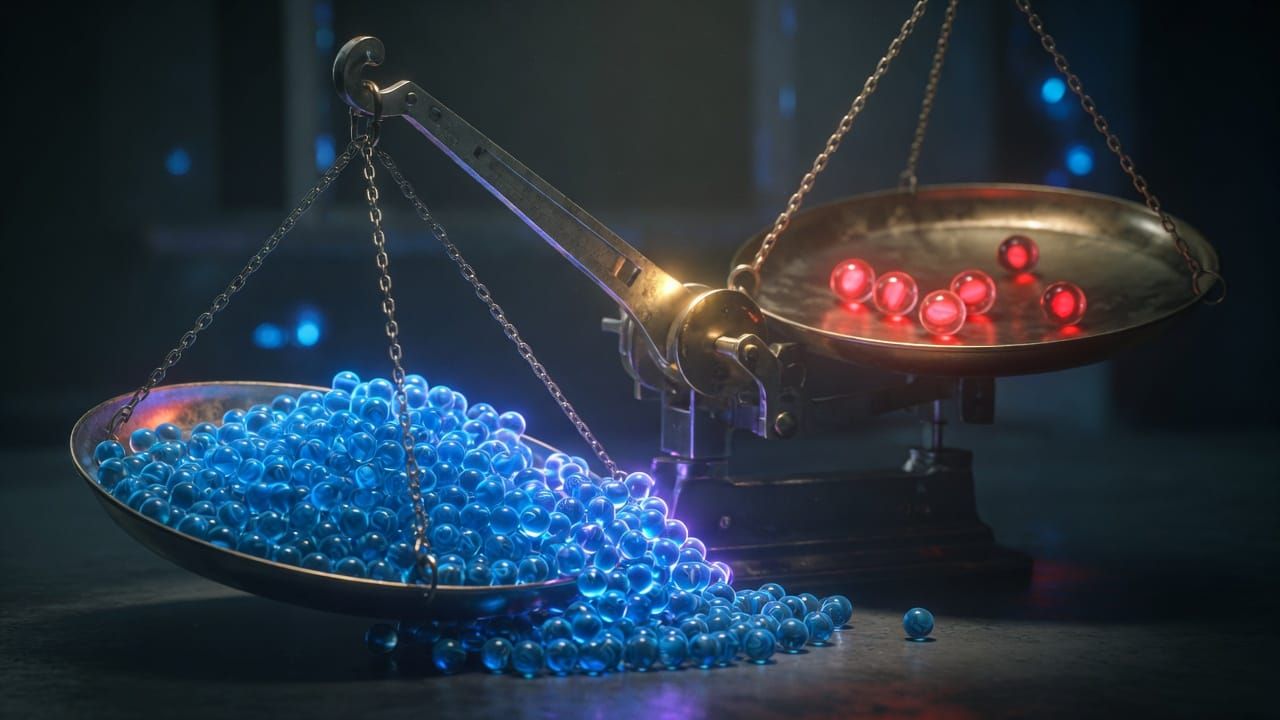
Les jeux de données déséquilibrés sont un défi courant en intelligence artificielle. Lorsqu'une classe représente 99 % des exemples et l'autre seulement 1 %, les modèles standards échouent souvent à détecter les cas rares. Ce phénomène touche de nombreux domaines concrets et nécessite des approches spécifiques pour éviter des prédictions biaisées.
Qu'est-ce qu'un dataset déséquilibré et pourquoi pose-t-il problème ?
Un dataset est déséquilibré lorsque la distribution des classes est très inégale. Par exemple, dans la détection de fraude bancaire, moins de 0,5 % des transactions sont frauduleuses. En médecine, la détection de maladies rares comme certains cancers touche parfois 1 patient sur 1000. Le churn client, le spam ou les défauts industriels suivent le même schéma.
Le modèle « triche » alors en prédisant systématiquement la classe majoritaire. Il obtient une accuracy élevée tout en manquant complètement les cas minoritaires, ce qui rend le système inutilisable en pratique.
Le piège de l'accuracy et les métriques à privilégier
L'accuracy est trompeuse car elle reflète surtout la performance sur la classe majoritaire. Il faut donc utiliser des métriques plus adaptées : la matrice de confusion, la précision, le rappel (recall), le score F1, la balanced accuracy, le coefficient de Cohen kappa et surtout la PR-AUC (aire sous la courbe précision-rappel) qui est souvent plus pertinente que la ROC-AUC en cas de fort déséquilibre.
- Privilégiez le rappel quand les faux négatifs sont coûteux (maladie non détectée).
- Privilégiez la précision quand les faux positifs sont coûteux (alarme fraude inutile).
Techniques de ré-échantillonnage
Le ré-échantillonnage modifie la distribution des classes. L'oversampling duplique ou génère des exemples minoritaires (SMOTE, ADASYN, Borderline-SMOTE). L'undersampling réduit la classe majoritaire (Random Undersampling, Tomek Links, NearMiss, ENN). Des combinaisons comme SMOTETomek ou SMOTEENN offrent souvent un bon compromis.
- Avantages : améliore la détection de la classe rare.
- Risques : overfitting avec duplication simple, perte d'information avec undersampling excessif.
Approches au niveau algorithme
Plutôt que modifier les données, on peut adapter l'algorithme. Le paramètre class_weight dans scikit-learn pénalise les erreurs sur la classe minoritaire. Le cost-sensitive learning et le focal loss accentuent l'importance des exemples difficiles. L'ajustement du seuil de décision (threshold moving) permet d'optimiser le rappel ou la précision après l'entraînement.
Méthodes ensemblistes spécialisées
Les méthodes ensemblistes combinent plusieurs modèles entraînés sur des sous-ensembles équilibrés. BalancedRandomForest, EasyEnsemble, RUSBoost et BalancedBagging sont des variantes robustes qui intègrent naturellement le déséquilibre et réduisent le risque d'overfitting.
Quand passer au cadre détection d'anomalie
Quand la classe rare représente moins de 1 % des données, les techniques de classification classiques deviennent inefficaces. Il est alors préférable de basculer vers des approches de détection d'anomalie (Isolation Forest, One-Class SVM, autoencodeurs) qui modélisent uniquement la classe majoritaire et signalent les écarts.
Bonnes pratiques de validation et pipelines
Le resampling ne doit jamais être appliqué sur l'ensemble de test ou de validation, sous peine de fuite de données. Utilisez toujours un stratified k-fold et construisez un pipeline avec imbalanced-learn pour garantir que SMOTE ou tout autre technique ne s'applique que sur les folds d'entraînement.
Exemple concret de code avec imbalanced-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(n_classes=2, weights=[0.95, 0.05], n_samples=10000, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y, test_size=0.2, random_state=42)

pipeline = Pipeline([
    ('over', SMOTE(sampling_strategy=0.3, random_state=42)),
    ('under', RandomUnderSampler(sampling_strategy=0.5, random_state=42)),
    ('clf', RandomForestClassifier(class_weight='balanced', random_state=42))
])

pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
Ce pipeline applique SMOTE et undersampling uniquement sur les données d'entraînement et utilise le class_weight pour renforcer la robustesse.
Checklist pratique pour vos projets
- Analyser la distribution des classes avant tout entraînement.
- Choisir les métriques adaptées (F1, PR-AUC, balanced accuracy).
- Appliquer le resampling uniquement sur le train via un pipeline.
- Tester plusieurs techniques (SMOTE, class_weight, seuils).
- Utiliser la validation croisée stratifiée.
- Comparer les approches sur un jeu de test intact.
En résumé, les datasets déséquilibrés exigent une attention particulière à chaque étape du projet. En combinant métriques pertinentes, techniques de ré-échantillonnage maîtrisées et pipelines rigoureux, vous obtiendrez des modèles fiables même lorsque les classes rares sont critiques. Expérimentez progressivement ces méthodes sur vos propres données pour constater leur impact concret.
💬 Une question ou envie d'aller plus loin ? Rejoins la communauté sur Discord : https://discord.gg/GwhUKccQcM