Conjuntos de dados desbalanceados: como gerenciá-los de forma eficaz
Guia completo para compreender e tratar os datasets desbalanceados em IA com métricas, técnicas e exemplos concretos.
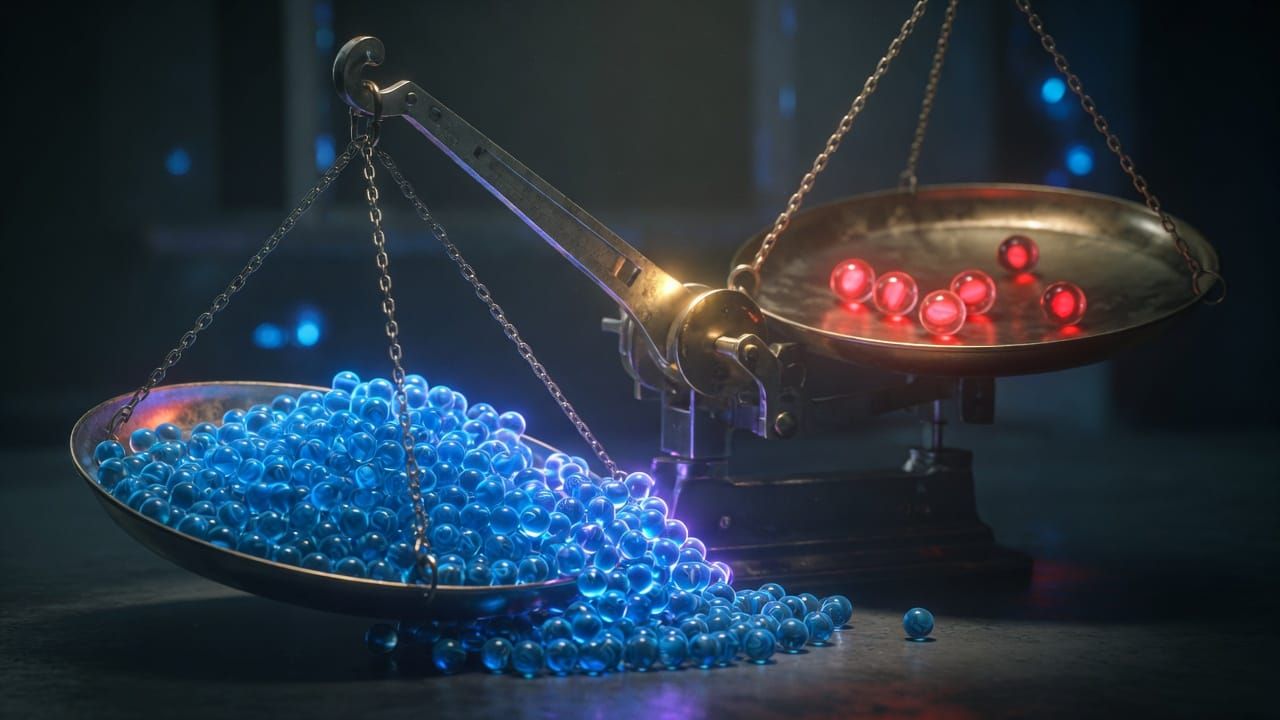
Conjuntos de dados desbalanceados são um desafio comum em inteligência artificial. Quando uma classe representa 99 % dos exemplos e a outra apenas 1 %, os modelos padrão frequentemente falham em detectar os casos raros. Esse fenômeno afeta muitos domínios concretos e requer abordagens específicas para evitar previsões enviesadas.
O que é um dataset desbalanceado e por que isso é um problema?
Um dataset está desbalanceado quando a distribuição das classes é muito desigual. Por exemplo, na detecção de fraude bancária, menos de 0,5% das transações são fraudulentas. Na medicina, a detecção de doenças raras como alguns cânceres atinge às vezes 1 paciente em 1000. O churn de clientes, o spam ou os defeitos industriais seguem o mesmo padrão.
O modelo “trapaceia” prevendo sistematicamente a classe majoritária. Ele obtém uma acurácia elevada ao mesmo tempo em que perde completamente os casos minoritários, o que torna o sistema inutilizável na prática.
A armadilha da acurácia e as métricas a priorizar
A acurácia é enganosa porque reflete principalmente o desempenho na classe majoritária. Portanto, é preciso usar métricas mais adequadas: a matriz de confusão, a precisão, o recall (recall), o score F1, a acurácia balanceada, o coeficiente kappa de Cohen e, principalmente, a PR-AUC (área sob a curva precisão-recall), que costuma ser mais relevante que a ROC-AUC em caso de forte desequilíbrio.
- Priorize o recall quando os falsos negativos forem custosos (doença não detectada).
- Priorize a precisão quando os falsos positivos forem custosos (alarme de fraude desnecessário).
Técnicas de reamostragem
O reamostragem modifica a distribuição das classes. O oversampling duplica ou gera exemplos minoritários (SMOTE, ADASYN, Borderline-SMOTE). O undersampling reduz a classe majoritária (Random Undersampling, Tomek Links, NearMiss, ENN). Combinações como SMOTETomek ou SMOTEENN frequentemente oferecem um bom compromisso.
- Vantagens: melhora a detecção da classe rara.
- Riscos: overfitting com duplicação simples, perda de informação com undersampling excessivo.
Abordagens em nível de algoritmo
Em vez de modificar os dados, podemos adaptar o algoritmo. O parâmetro class_weight no scikit-learn penaliza os erros na classe minoritária. O cost-sensitive learning e o focal loss aumentam a importância dos exemplos difíceis. O ajuste do limiar de decisão (threshold moving) permite otimizar o recall ou a precisão após o treinamento.
Métodos ensemble especializados
Os métodos ensemble combinam vários modelos treinados em subconjuntos balanceados. BalancedRandomForest, EasyEnsemble, RUSBoost e BalancedBagging são variantes robustas que integram naturalmente o desbalanceamento e reduzem o risco de overfitting.
Quando migrar para o framework de detecção de anomalias
Quando a classe rara representa menos de 1% dos dados, as técnicas clássicas de classificação tornam-se ineficazes. É então preferível migrar para abordagens de detecção de anomalias (Isolation Forest, One-Class SVM, autoencoders) que modelam apenas a classe majoritária e sinalizam os desvios.
Boas práticas de validação e pipelines
O resampling nunca deve ser aplicado no conjunto de teste ou de validação, sob pena de vazamento de dados. Use sempre um stratified k-fold e construa um pipeline com imbalanced-learn para garantir que o SMOTE ou qualquer outra técnica se aplique apenas nos folds de treinamento.
Exemplo concreto de código com imbalanced-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(n_classes=2, weights=[0.95, 0.05], n_samples=10000, random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y, test_size=0.2, random_state=42)

pipeline = Pipeline([
    ('over', SMOTE(sampling_strategy=0.3, random_state=42)),
    ('under', RandomUnderSampler(sampling_strategy=0.5, random_state=42)),
    ('clf', RandomForestClassifier(class_weight='balanced', random_state=42))
])

pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
Este pipeline aplica SMOTE e undersampling apenas nos dados de treinamento e utiliza o class_weight para reforçar a robustez.
Checklist prática para seus projetos
- Analise a distribuição das classes antes de qualquer treinamento.
- Escolha as métricas adequadas (F1, PR-AUC, balanced accuracy).
- Aplique o resampling apenas no train via um pipeline.
- Teste várias técnicas (SMOTE, class_weight, thresholds).
- Use a validação cruzada estratificada.
- Compare as abordagens em um conjunto de teste intacto.
Em resumo, os datasets desbalanceados exigem atenção especial em cada etapa do projeto. Ao combinar métricas relevantes, técnicas de reamostragem controladas e pipelines rigorosos, você obterá modelos confiáveis mesmo quando as classes raras são críticas. Experimente essas abordagens progressivamente em seus próprios dados para observar seu impacto concreto.
💬 Alguma dúvida ou quer ir mais longe? Junte-se à comunidade no Discord: https://discord.gg/GwhUKccQcM