La descente de gradient expliquée simplement : le moteur de l'apprentissage automatique
Comprenez comment cet algorithme optimise les modèles d'IA en minimisant les erreurs, avec des exemples concrets pour débutants.
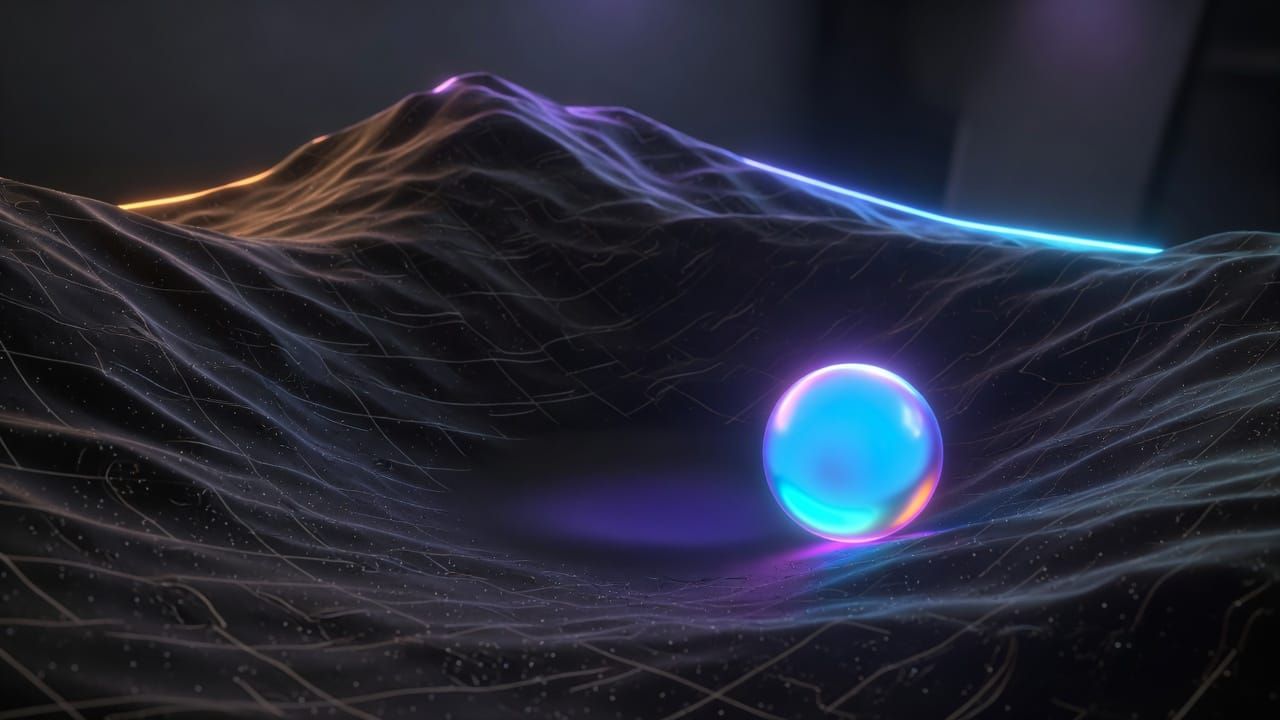
Imaginez que vous êtes perdu dans une vallée brumeuse et que vous cherchez le point le plus bas pour vous orienter. Chaque pas que vous faites dépend de la pente sous vos pieds : vous descendez là où la pente est la plus forte. C’est exactement ce que fait la descente de gradient en intelligence artificielle : un algorithme qui guide un modèle vers la meilleure solution en ajustant ses paramètres petit à petit.
Le principe intuitif derrière la descente de gradient
En machine learning, un modèle apprend en minimisant une fonction de coût qui mesure l’écart entre ses prédictions et la réalité. La descente de gradient calcule la pente de cette fonction à chaque point et met à jour les paramètres dans la direction opposée à la pente. Plus la pente est raide, plus les ajustements sont importants au début. Au fur et à mesure, le modèle ralentit près du minimum, comme un randonneur qui freine en arrivant au fond de la vallée.
- La fonction de coût représente l’erreur globale du modèle.
- Le gradient indique la direction et l’intensité de la pente.
- Le taux d’apprentissage contrôle la taille des pas effectués.
Un exemple concret avec une régression linéaire
Supposons que nous voulions prédire le prix d’un appartement en fonction de sa surface. Nous commençons avec des paramètres aléatoires pour la droite de régression. À chaque itération, la descente de gradient calcule l’erreur moyenne sur toutes les données et ajuste la pente et l’ordonnée à l’origine. Après quelques centaines d’itérations, la droite s’aligne progressivement sur les points réels du jeu de données.
theta = theta - learning_rate * gradientLes variantes les plus utilisées
La version classique, appelée descente de gradient par batch, utilise toutes les données à chaque pas. Elle est précise mais lente sur de gros volumes. La descente de gradient stochastique (SGD) met à jour les paramètres après chaque exemple, ce qui accélère l’apprentissage mais rend la trajectoire plus bruyante. Entre les deux, le mini-batch combine les avantages des deux approches et domine aujourd’hui les frameworks modernes comme TensorFlow ou PyTorch.
- Batch : calcul complet, convergence stable mais coûteuse.
- SGD : mises à jour rapides, risque d’oscillations.
- Mini-batch : compromis idéal pour la plupart des cas.
Applications concrètes en IA
La descente de gradient est au cœur des réseaux de neurones, de la vision par ordinateur et du traitement du langage naturel. Quand un modèle de reconnaissance d’images apprend à distinguer un chat d’un chien, il ajuste des millions de poids grâce à cette méthode. Sans elle, l’entraînement de modèles comme GPT ou Stable Diffusion serait impossible à grande échelle.
Pièges courants et comment les éviter
Un taux d’apprentissage trop élevé fait osciller le modèle sans converger, tandis qu’un taux trop faible ralentit énormément l’apprentissage. Les minima locaux peuvent aussi piéger l’algorithme dans des solutions sous-optimales. Des techniques comme l’élan (momentum) ou l’ajustement adaptatif du taux d’apprentissage (Adam) aident à surmonter ces difficultés.
La descente de gradient reste l’outil fondamental qui permet à l’IA d’apprendre à partir des données. En comprenant son fonctionnement, vous posez les bases pour explorer des algorithmes plus avancés et concevoir vos propres modèles avec confiance.
💬 Une question ou envie d'aller plus loin ? Rejoins la communauté sur Discord : https://discord.gg/GwhUKccQcM