Gérer les jeux de données déséquilibrés : techniques et bonnes pratiques
Comprendre les datasets déséquilibrés et maîtriser les méthodes pour entraîner des modèles fiables en classification.
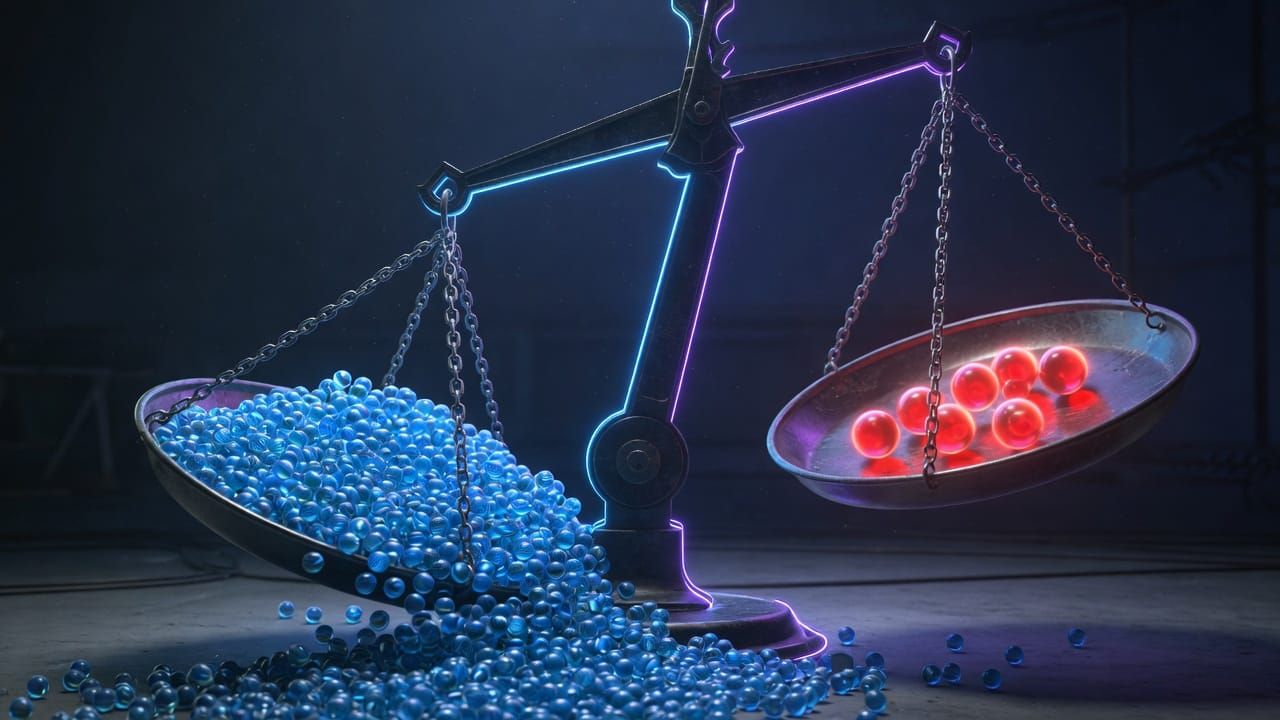
Les jeux de données déséquilibrés constituent un défi majeur en apprentissage automatique. Lorsqu’une classe représente 99 % des exemples et l’autre seulement 1 %, les algorithmes classiques ont tendance à « tricher » en prédisant toujours la classe majoritaire. Cet article vous guide pas à pas pour identifier, mesurer et corriger ce problème avec des techniques éprouvées.
1. Qu’est-ce qu’un dataset déséquilibré et pourquoi est-ce un problème ?
Un dataset est déséquilibré lorsque la répartition des classes est très inégale. Les exemples concrets abondent : détection de fraude bancaire (0,1 % de transactions frauduleuses), diagnostic médical de maladies rares, prédiction de churn client, filtrage de spam ou détection de défauts industriels. Dans tous ces cas, le modèle qui prédit systématiquement la classe majoritaire obtient une accuracy élevée tout en étant totalement inutile.
2. Le piège de l’accuracy et les métriques adaptées
L’accuracy est trompeuse car elle masque les erreurs sur la classe minoritaire. Il faut privilégier la matrice de confusion, la précision, le rappel, le score F1, la balanced accuracy, le Cohen’s Kappa et surtout la PR-AUC (plus pertinente que la ROC-AUC quand les classes sont très déséquilibrées). On privilégie le rappel lorsque les faux négatifs sont coûteux (maladie manquée) et la précision lorsque les faux positifs le sont (alerte fraude inutile).
3. Techniques de ré-échantillonnage
L’oversampling duplique ou synthétise des exemples minoritaires (SMOTE, ADASYN, Borderline-SMOTE). L’undersampling supprime des exemples majoritaires (Random, Tomek links, NearMiss, ENN). Les combinaisons comme SMOTETomek ou SMOTEENN offrent souvent le meilleur compromis. Attention : l’oversampling peut provoquer du surapprentissage et l’undersampling une perte d’information précieuse.
4. Approches au niveau algorithme
Les algorithmes peuvent intégrer directement le déséquilibre via les paramètres class_weight ou cost-sensitive learning. Ajuster le seuil de décision (threshold moving) permet d’optimiser le rappel ou la précision selon les besoins métier. La Focal Loss, utilisée en deep learning, réduit l’impact des exemples faciles et concentre l’apprentissage sur les cas difficiles.
5. Méthodes ensemblistes spécialisées
Les méthodes ensemblistes adaptées incluent BalancedRandomForest, EasyEnsemble, RUSBoost et BalancedBagging. Elles combinent ré-échantillonnage et agrégation de modèles pour améliorer la robustesse tout en limitant le surapprentissage.
6. Passage en mode détection d’anomalie
Quand la classe rare représente moins de 1 % des données, il devient pertinent de basculer vers des approches de détection d’anomalie (Isolation Forest, One-Class SVM, autoencodeurs). Ces méthodes modélisent uniquement la classe majoritaire et signalent les points qui s’en écartent fortement.
7. Bonnes pratiques de validation
Le resampling ne doit jamais être appliqué sur l’ensemble de test ou de validation. Utilisez toujours un pipeline (imblearn.Pipeline) et une stratified k-fold cross-validation. Cela évite toute fuite de données et garantit une évaluation honnête des performances.
8. Exemple concret avec Python et imbalanced-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(n_classes=2, weights=[0.95, 0.05],
                           n_informative=4, flip_y=0, n_samples=5000,
                           random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y,
                                                    test_size=0.2, random_state=42)

pipeline = Pipeline([
    ('over', SMOTE(random_state=42)),
    ('under', RandomUnderSampler(random_state=42)),
    ('clf', RandomForestClassifier(class_weight='balanced', random_state=42))
])

pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
Conclusion : face à un dataset déséquilibré, commencez toujours par analyser la distribution des classes et choisir les bonnes métriques. Testez ensuite les techniques de ré-échantillonnage, les pondérations et les méthodes ensemblistes dans un pipeline rigoureux. Voici une checklist pratique pour ne rien oublier :
- Analyser la distribution des classes dès le début
- Utiliser stratified k-fold et pipelines imblearn
- Privilégier rappel, F1 et PR-AUC plutôt que l’accuracy
- Essayer SMOTE puis ajuster le seuil de décision
- Comparer class_weight et méthodes ensemblistes
- Basculer en détection d’anomalie si la minorité < 1 %
- Valider uniquement sur des données non ré-échantillonnées
💬 Une question ou envie d'aller plus loin ? Rejoins la communauté sur Discord : https://discord.gg/GwhUKccQcM