Gerenciando conjuntos de dados desbalanceados: técnicas e boas práticas
Compreender os datasets desbalanceados e dominar os métodos para treinar modelos confiáveis em classificação.
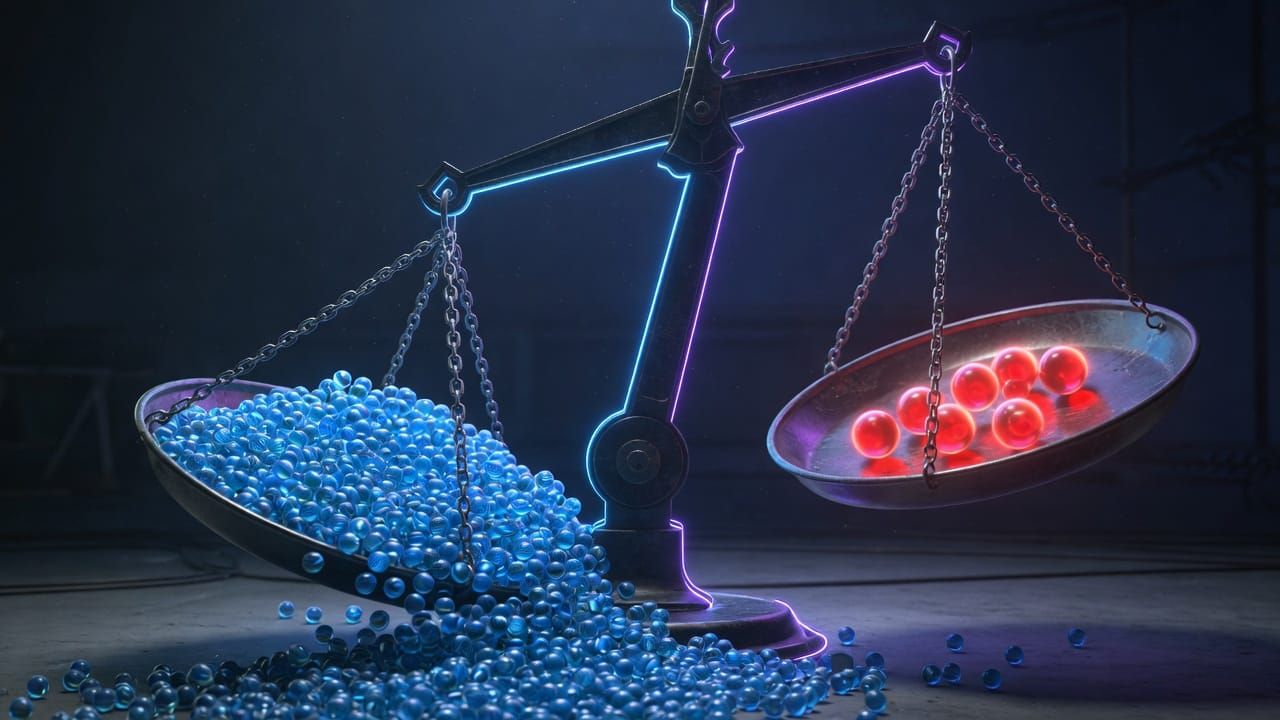
Os conjuntos de dados desbalanceados representam um desafio importante no aprendizado de máquina. Quando uma classe representa 99% dos exemplos e a outra apenas 1%, os algoritmos clássicos tendem a “trapacear” prevendo sempre a classe majoritária. Este artigo o guia passo a passo para identificar, medir e corrigir esse problema com técnicas comprovadas.
1. O que é um dataset desbalanceado e por que isso é um problema?
Um dataset é desbalanceado quando a distribuição das classes é muito desigual. Os exemplos concretos são abundantes: detecção de fraude bancária (0,1 % de transações fraudulentas), diagnóstico médico de doenças raras, previsão de churn de clientes, filtragem de spam ou detecção de defeitos industriais. Em todos esses casos, o modelo que prevê sistematicamente a classe majoritária obtém uma accuracy elevada, embora seja totalmente inútil.
2. A armadilha da acurácia e as métricas adequadas
A acurácia é enganosa porque mascara os erros na classe minoritária. É preciso priorizar a matriz de confusão, a precisão, o recall, o F1-score, a balanced accuracy, o Cohen’s Kappa e principalmente a PR-AUC (mais relevante que a ROC-AUC quando as classes estão muito desbalanceadas). Prioriza-se o recall quando os falsos negativos são custosos (doença não detectada) e a precisão quando os falsos positivos o são (alerta de fraude desnecessário).
3. Técnicas de reamostragem
O oversampling duplica ou sintetiza exemplos minoritários (SMOTE, ADASYN, Borderline-SMOTE). O undersampling remove exemplos majoritários (Random, Tomek links, NearMiss, ENN). As combinações como SMOTETomek ou SMOTEENN oferecem frequentemente o melhor compromisso. Atenção: o oversampling pode provocar overfitting e o undersampling uma perda de informação valiosa.
4. Abordagens no nível do algoritmo
Os algoritmos podem integrar diretamente o desequilíbrio por meio dos parâmetros class_weight ou cost-sensitive learning. Ajustar o limiar de decisão (threshold moving) permite otimizar o recall ou a precisão de acordo com as necessidades do negócio. A Focal Loss, utilizada em deep learning, reduz o impacto dos exemplos fáceis e concentra o aprendizado nos casos difíceis.
5. Métodos ensemble especializados
Os métodos ensemble adaptados incluem BalancedRandomForest, EasyEnsemble, RUSBoost e BalancedBagging. Eles combinam reamostragem e agregação de modelos para melhorar a robustez, ao mesmo tempo limitando o sobreajuste.
6. Mudança para o modo de detecção de anomalias
Quando a classe rara representa menos de 1% dos dados, torna-se pertinente mudar para abordagens de detecção de anomalias (Isolation Forest, One-Class SVM, autoencoders). Esses métodos modelam apenas a classe majoritária e sinalizam os pontos que se afastam fortemente dela.
7. Boas práticas de validação
O resampling nunca deve ser aplicado no conjunto de teste ou de validação. Use sempre um pipeline (imblearn.Pipeline) e uma stratified k-fold cross-validation. Isso evita qualquer vazamento de dados e garante uma avaliação honesta do desempenho.
8. Exemplo concreto com Python e imbalanced-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(n_classes=2, weights=[0.95, 0.05],
                           n_informative=4, flip_y=0, n_samples=5000,
                           random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y,
                                                    test_size=0.2, random_state=42)

pipeline = Pipeline([
    ('over', SMOTE(random_state=42)),
    ('under', RandomUnderSampler(random_state=42)),
    ('clf', RandomForestClassifier(class_weight='balanced', random_state=42))
])

pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
Conclusão: diante de um dataset desbalanceado, comece sempre analisando a distribuição das classes e escolhendo as métricas corretas. Em seguida, teste as técnicas de reamostragem, as ponderações e os métodos ensemble em um pipeline rigoroso. Aqui vai uma checklist prática para não esquecer nada:
- Analisar a distribuição das classes desde o início
- Usar stratified k-fold e pipelines imblearn
- Preferir recall, F1 e PR-AUC em vez de accuracy
- Tentar SMOTE e depois ajustar o limiar de decisão
- Comparar class_weight e métodos ensemble
- Mudar para detecção de anomalia se a minoria < 1 %
- Validar apenas em dados não reamostrados
💬 Tem alguma dúvida ou quer ir mais longe? Junte-se à comunidade no Discord: https://discord.gg/GwhUKccQcM