Manejo de conjuntos de datos desbalanceados: técnicas y buenas prácticas
Comprender los datasets desequilibrados y dominar los métodos para entrenar modelos fiables en clasificación.
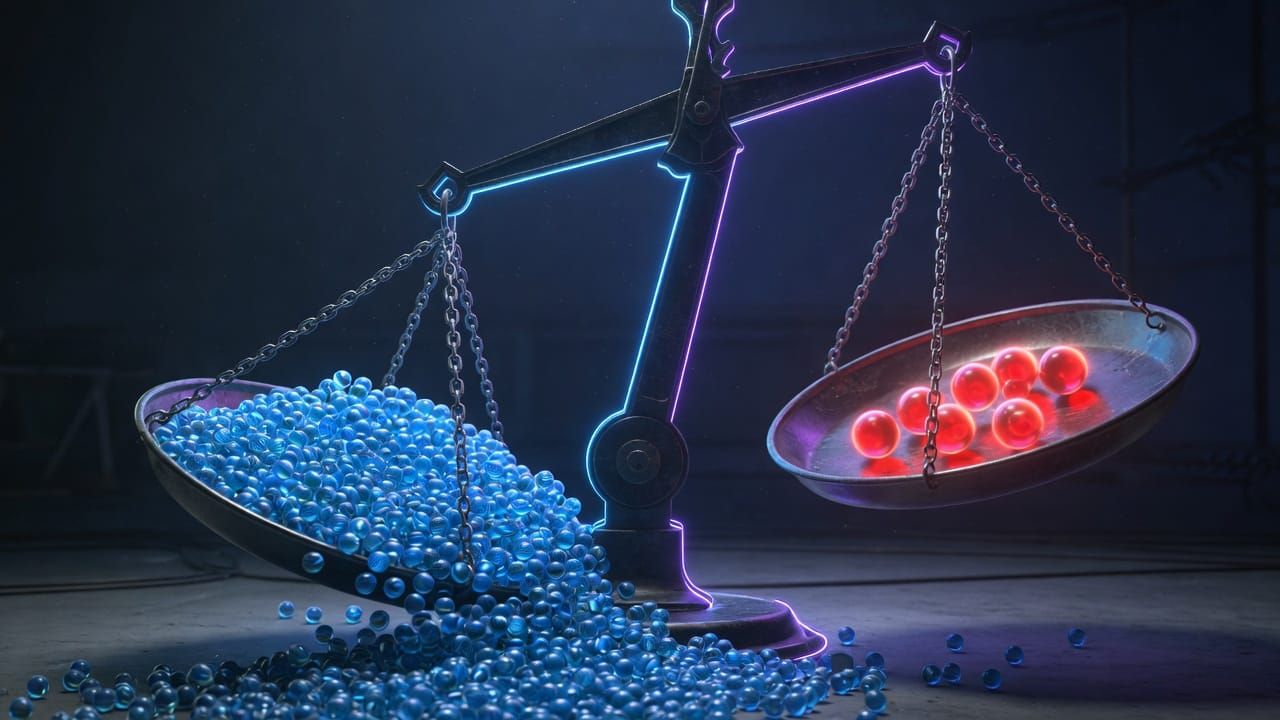
Los conjuntos de datos desequilibrados constituyen un desafío mayor en el aprendizaje automático. Cuando una clase representa el 99 % de los ejemplos y la otra solo el 1 %, los algoritmos clásicos tienden a «hacer trampa» prediciendo siempre la clase mayoritaria. Este artículo le guía paso a paso para identificar, medir y corregir este problema con técnicas probadas.
1. ¿Qué es un dataset desequilibrado y por qué es un problema?
Un dataset está desequilibrado cuando la distribución de las clases es muy desigual. Los ejemplos concretos abundan: detección de fraude bancario (0,1 % de transacciones fraudulentas), diagnóstico médico de enfermedades raras, predicción de churn de clientes, filtrado de spam o detección de defectos industriales. En todos estos casos, el modelo que predice sistemáticamente la clase mayoritaria obtiene una accuracy elevada al mismo tiempo que es totalmente inútil.
2. La trampa de la accuracy y las métricas adecuadas
La accuracy es engañosa porque oculta los errores en la clase minoritaria. Es necesario priorizar la matriz de confusión, la precisión, el recall, el score F1, la balanced accuracy, el Cohen’s Kappa y sobre todo la PR-AUC (más pertinente que la ROC-AUC cuando las clases están muy desequilibradas). Se prioriza el recall cuando los falsos negativos son costosos (enfermedad no detectada) y la precisión cuando lo son los falsos positivos (alerta de fraude innecesaria).
3. Técnicas de remuestreo
El oversampling duplica o sintetiza ejemplos minoritarios (SMOTE, ADASYN, Borderline-SMOTE). El undersampling elimina ejemplos mayoritarios (Random, Tomek links, NearMiss, ENN). Las combinaciones como SMOTETomek o SMOTEENN ofrecen a menudo el mejor compromiso. Atención: el oversampling puede provocar sobreajuste y el undersampling una pérdida de información valiosa.
4. Enfoques a nivel de algoritmo
Los algoritmos pueden integrar directamente el desequilibrio mediante los parámetros class_weight o cost-sensitive learning. Ajustar el umbral de decisión (threshold moving) permite optimizar el recall o la precisión según las necesidades del negocio. La Focal Loss, utilizada en deep learning, reduce el impacto de los ejemplos fáciles y concentra el aprendizaje en los casos difíciles.
5. Métodos de conjunto especializados
Los métodos de conjunto adaptados incluyen BalancedRandomForest, EasyEnsemble, RUSBoost y BalancedBagging. Combinan el remuestreo y la agregación de modelos para mejorar la robustez al tiempo que limitan el sobreajuste.
6. Cambio al modo detección de anomalías
Cuando la clase rara representa menos del 1 % de los datos, resulta pertinente cambiar a enfoques de detección de anomalías (Isolation Forest, One-Class SVM, autoencoders). Estos métodos modelan únicamente la clase mayoritaria y señalan los puntos que se alejan fuertemente de ella.
7. Buenas prácticas de validación
El resampling nunca debe aplicarse sobre el conjunto de test o de validación. Utilice siempre un pipeline (imblearn.Pipeline) y una stratified k-fold cross-validation. Esto evita cualquier fuga de datos y garantiza una evaluación honesta del rendimiento.
8. Ejemplo concreto con Python e imbalanced-learn
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from imblearn.pipeline import Pipeline
from imblearn.over_sampling import SMOTE
from imblearn.under_sampling import RandomUnderSampler

X, y = make_classification(n_classes=2, weights=[0.95, 0.05],
                           n_informative=4, flip_y=0, n_samples=5000,
                           random_state=42)
X_train, X_test, y_train, y_test = train_test_split(X, y, stratify=y,
                                                    test_size=0.2, random_state=42)

pipeline = Pipeline([
    ('over', SMOTE(random_state=42)),
    ('under', RandomUnderSampler(random_state=42)),
    ('clf', RandomForestClassifier(class_weight='balanced', random_state=42))
])

pipeline.fit(X_train, y_train)
y_pred = pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
Conclusión: ante un dataset desequilibrado, empiece siempre analizando la distribución de las clases y eligiendo las métricas adecuadas. Pruebe a continuación las técnicas de remuestreo, las ponderaciones y los métodos de conjunto en un pipeline riguroso. Aquí tiene una lista de verificación práctica para no olvidar nada:
- Analizar la distribución de las clases desde el principio
- Utilizar stratified k-fold y pipelines de imblearn
- Priorizar recall, F1 y PR-AUC en lugar de accuracy
- Probar SMOTE y luego ajustar el umbral de decisión
- Comparar class_weight y métodos de conjunto
- Cambiar a detección de anomalías si la minoría < 1 %
- Validar únicamente en datos no remuestreados
💬 ¿Tienes alguna pregunta o quieres profundizar más? Únete a la comunidad en Discord : https://discord.gg/GwhUKccQcM