Classificação vs Regressão: Dominando as Duas Abordagens-Chave do Aprendizado Supervisionado
Aprenda a distinguir classificação e regressão em IA por meio de exemplos concretos e conselhos práticos para escolher bem o seu modelo.
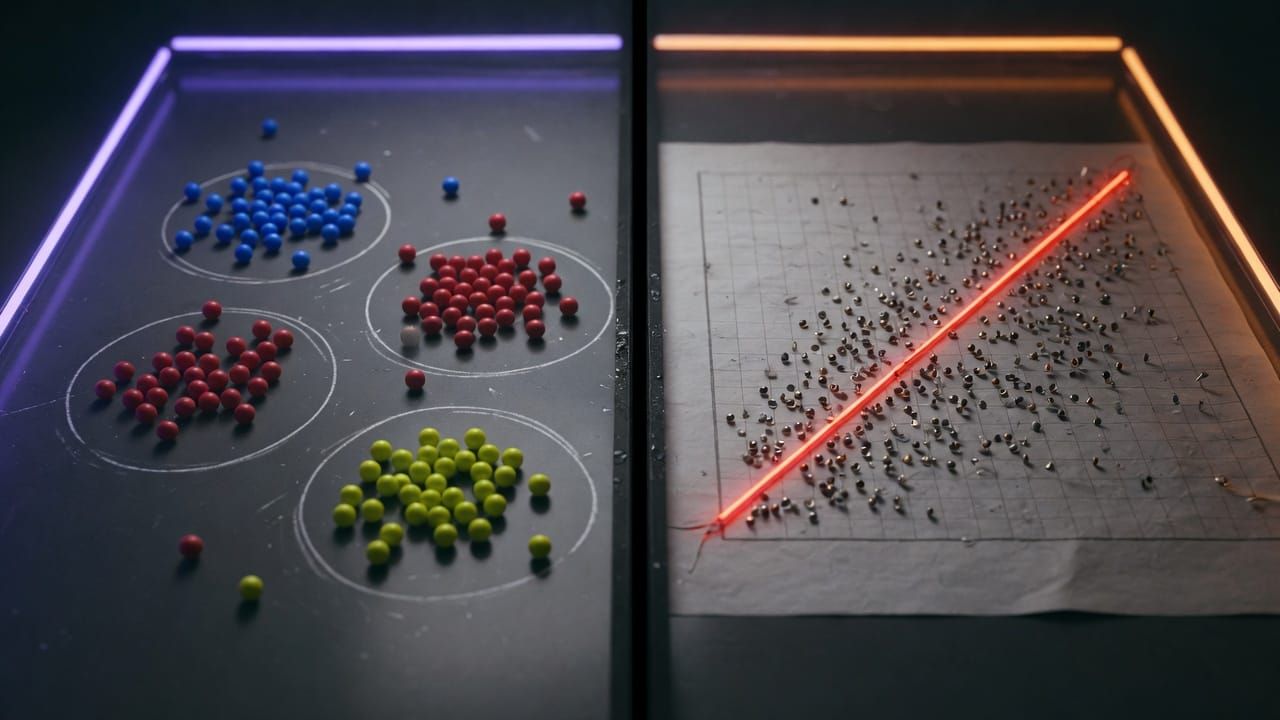
No mundo da inteligência artificial, o aprendizado supervisionado é uma das técnicas mais utilizadas. Dois métodos dominam esse domínio: a classificação e a regressão. Compreender suas diferenças permite resolver eficientemente muitos problemas concretos, do diagnóstico médico à previsão de vendas.
O que é o aprendizado supervisionado?
O aprendizado supervisionado consiste em treinar um modelo a partir de dados rotulados. Você fornece ao sistema exemplos com entradas e saídas conhecidas, para que ele aprenda a prever a saída para novos dados. É como ensinar uma criança a reconhecer frutas mostrando maçãs e bananas já identificadas. Essa abordagem se divide principalmente em duas categorias de acordo com a natureza da saída esperada.
A regressão: prever valores contínuos
A regressão visa prever um valor numérico contínuo. Por exemplo, estimar o preço de uma casa com base em sua área, localização e número de quartos. O modelo aprende a traçar uma linha ou uma curva que minimiza a diferença entre suas previsões e os valores reais. Os algoritmos comuns incluem a regressão linear ou as florestas aleatórias para relações mais complexas. O objetivo é minimizar o erro em valores que podem ser qualquer número real.
A classificação: atribuir categorias
A classificação, por sua vez, atribui um rótulo discreto ou uma categoria. Pense em detectar se um e-mail é spam ou não, ou em identificar uma espécie de flor a partir de medidas de pétalas. O modelo aprende a separar os dados em classes distintas. Costuma-se usar a regressão logística, as árvores de decisão ou as redes neurais. A saída é geralmente uma probabilidade ou uma classe precisa, como « spam » ou « não spam ».
Principais diferenças entre as duas abordagens
A principal distinção reside na natureza da variável alvo: contínua para a regressão, discreta para a classificação. Na regressão, um erro é medido em distância numérica (ex.: o desvio de preço), enquanto na classificação avalia-se a taxa de boas previsões ou a matriz de confusão. As métricas também diferem: RMSE para a regressão, precisão ou recall para a classificação. Por fim, os problemas de classificação frequentemente lidam com desequilíbrios de classes, ao contrário da regressão.
Exemplos concretos e escolha de algoritmos
Imaginemos um projeto de previsão do tempo: regressão para estimar a temperatura exata de amanhã, classificação para dizer se vai chover ou não. Outro caso: prever a receita futura de um cliente (regressão) versus determinar se ele vai cancelar sua assinatura (classificação). Aqui está um exemplo simples em Python com scikit-learn:
from sklearn.linear_model import LinearRegression, LogisticRegression
# Regressão : prever um preço
model_reg = LinearRegression()
# Classificação : prever uma classe
model_clf = LogisticRegression()
Como escolher entre classificação e regressão?
Observe primeiro sua variável alvo: ela é um número contínuo ou uma categoria? Em seguida, teste a distribuição dos dados e a questão de negócio. Se você quiser um valor preciso como um montante, opte pela regressão. Para decisões binárias ou multiclasses, a classificação é adequada. Não hesite em transformar um problema (por exemplo, agrupar idades em faixas) para passar de uma abordagem para outra conforme suas necessidades.
Em conclusão, classificação e regressão são complementares e cobrem a maioria dos casos de uso em aprendizado supervisionado. Dominar suas diferenças o ajudará a conceber soluções de IA mais relevantes e performáticas desde seus primeiros projetos.
💬 Uma pergunta ou vontade de ir mais longe? Junte-se à comunidade no Discord: https://discord.gg/GwhUKccQcM