Clasificación vs Regresión: Dominar los dos enfoques clave del aprendizaje supervisado
Aprenda a distinguir entre clasificación y regresión en IA gracias a ejemplos concretos y consejos prácticos para elegir bien su modelo.
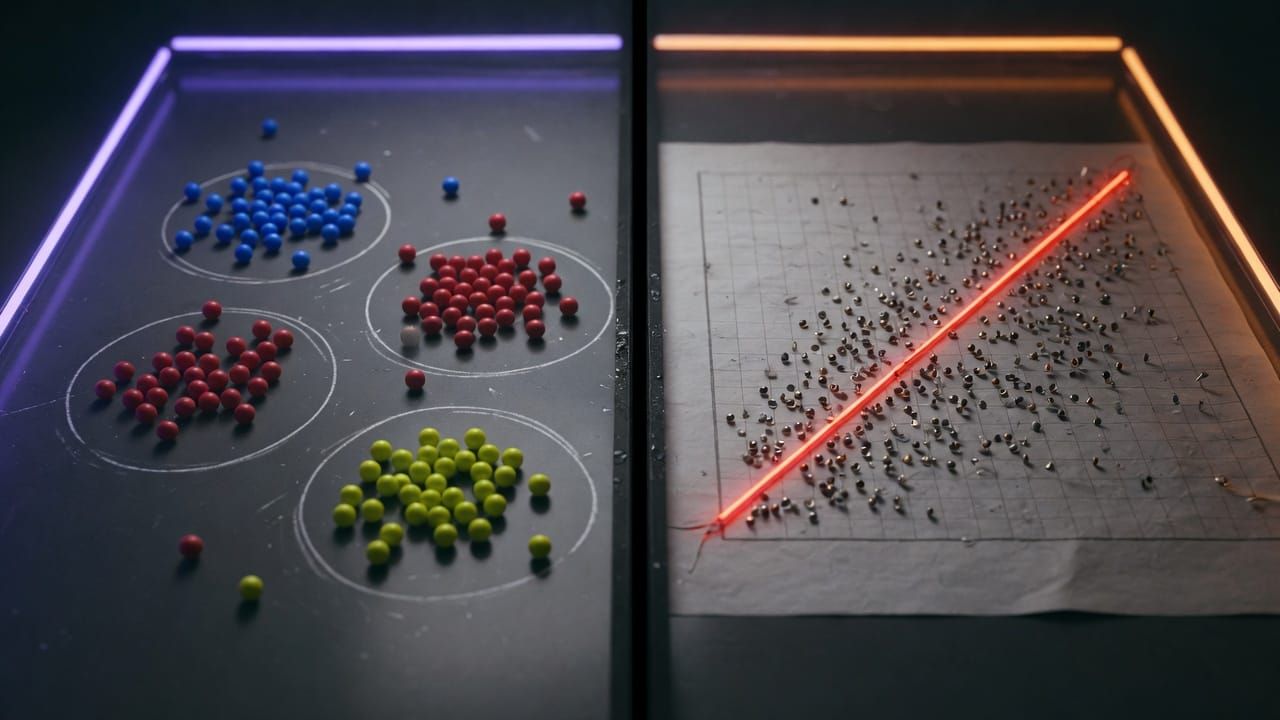
En el mundo de la inteligencia artificial, el aprendizaje supervisado es una de las técnicas más utilizadas. Dos métodos dominan este campo: la clasificación y la regresión. Comprender sus diferencias permite resolver eficazmente muchos problemas concretos, desde el diagnóstico médico hasta la previsión de ventas.
¿Qué es el aprendizaje supervisado?
El aprendizaje supervisado consiste en entrenar un modelo a partir de datos etiquetados. Usted proporciona al sistema ejemplos con entradas y salidas conocidas, para que aprenda a predecir la salida para nuevos datos. Es como enseñarle a un niño a reconocer frutas mostrándole manzanas y plátanos ya identificados. Este enfoque se divide principalmente en dos categorías según la naturaleza de la salida esperada.
La regresión: predecir valores continuos
La regresión tiene como objetivo predecir un valor numérico continuo. Por ejemplo, estimar el precio de una casa en función de su superficie, su ubicación y el número de habitaciones. El modelo aprende a trazar una línea o una curva que minimiza la diferencia entre sus predicciones y los valores reales. Los algoritmos comunes incluyen la regresión lineal o los bosques aleatorios para relaciones más complejas. El objetivo es minimizar el error en valores que pueden ser cualquier número real.
La clasificación: asignar categorías
La clasificación, por su parte, asigna una etiqueta discreta o una categoría. Piense en detectar si un correo electrónico es spam o no, o en identificar una especie de flor a partir de medidas de pétalos. El modelo aprende a separar los datos en clases distintas. Se utilizan a menudo la regresión logística, los árboles de decisión o las redes neuronales. La salida es generalmente una probabilidad o una clase precisa, como «spam» o «no spam».
Diferencias clave entre los dos enfoques
La principal distinción radica en la naturaleza de la variable objetivo: continua para la regresión, discreta para la clasificación. En regresión, un error se mide en distancia numérica (ej.: la diferencia de precio), mientras que en clasificación se evalúa la tasa de predicciones correctas o la matriz de confusión. Las métricas también difieren: RMSE para la regresión, precisión o recall para la clasificación. Por último, los problemas de clasificación suelen manejar desequilibrios de clases, a diferencia de la regresión.
Ejemplos concretos y elección de algoritmos
Imaginemos un proyecto de previsión meteorológica: regresión para estimar la temperatura exacta de mañana, clasificación para decir si lloverá o no. Otro caso: predecir los ingresos futuros de un cliente (regresión) versus determinar si va a cancelar su suscripción (clasificación). Aquí hay un ejemplo simple en Python con scikit-learn:
from sklearn.linear_model import LinearRegression, LogisticRegression
# Regresión: predecir un precio
model_reg = LinearRegression()
# Clasificación: predecir una clase
model_clf = LogisticRegression()
¿Cómo elegir entre clasificación y regresión?
Observe primero su variable objetivo: ¿es un número continuo o una categoría? A continuación, pruebe la distribución de los datos y la cuestión empresarial. Si desea un valor preciso como un monto, opte por la regresión. Para decisiones binarias o multiclase, la clasificación es adecuada. No dude en transformar un problema (por ejemplo, agrupar edades en tramos) para pasar de un enfoque a otro según sus necesidades.
En conclusión, la clasificación y la regresión son complementarias y cubren la mayoría de los casos de uso en aprendizaje supervisado. Dominar sus diferencias le ayudará a diseñar soluciones de IA más pertinentes y eficientes desde sus primeros proyectos.
💬 ¿Una pregunta o ganas de ir más lejos? Únete a la comunidad en Discord : https://discord.gg/GwhUKccQcM