التصنيف مقابل الانحدار: إتقان النهجين الرئيسيين للتعلم الخاضع للإشراف
تعلم التمييز بين التصنيف والانحدار في الذكاء الاصطناعي من خلال أمثلة ملموسة ونصائح عملية لاختيار نموذجك بشكل صحيح.
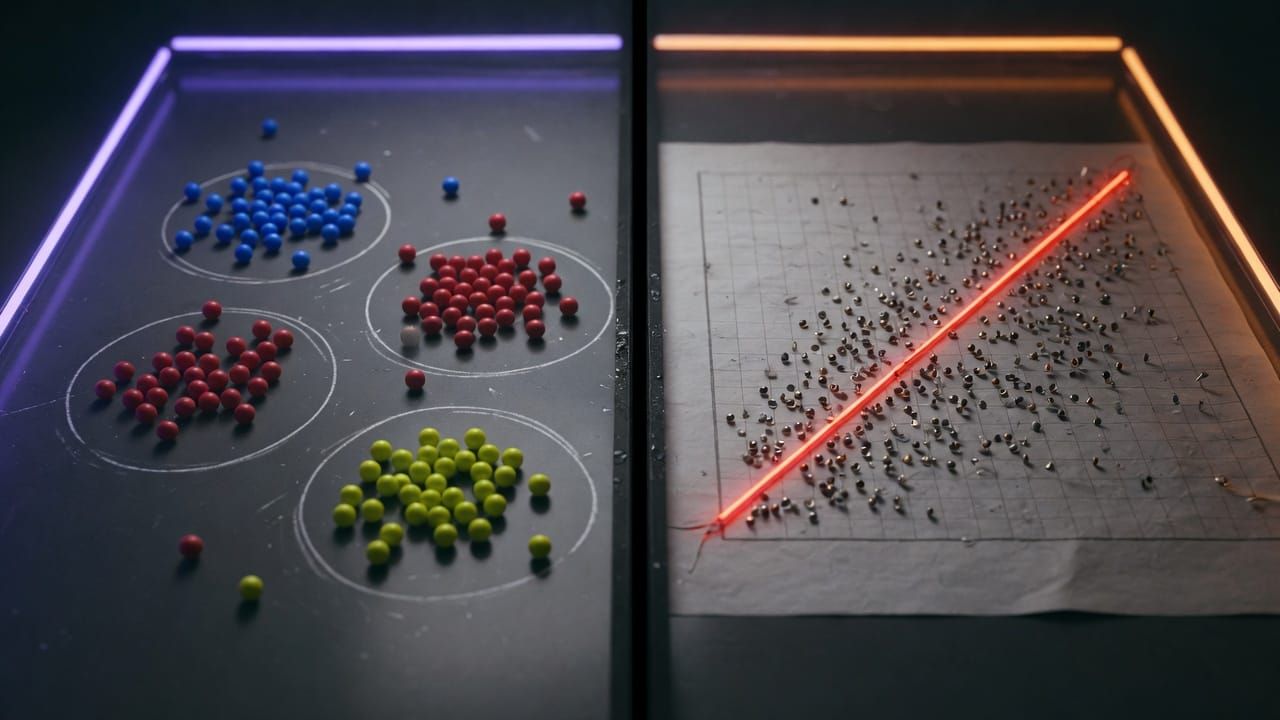
في عالم الذكاء الاصطناعي، يُعد التعلم الخاضع للإشراف أحد أكثر التقنيات استخدامًا. تهيمن طريقتان على هذا المجال: التصنيف والانحدار. يتيح فهم الاختلافات بينهما حل العديد من المشكلات الواقعية بفعالية، من التشخيص الطبي إلى التنبؤ بالمبيعات.
ما هو التعلم الخاضع للإشراف؟
يتضمن التعلم الخاضع للإشراف تدريب نموذج باستخدام بيانات مُعَلَّمة. تقدم للنظام أمثلة تحتوي على مدخلات ومخرجات معروفة، حتى يتعلم التنبؤ بالمخرج للبيانات الجديدة. وهذا يشبه تعليم طفل التعرف على الفواكه من خلال إظهار تفاح وموز محددة مسبقًا. ينقسم هذا النهج بشكل أساسي إلى فئتين رئيسيتين حسب طبيعة المخرج المتوقع.
الانحدار: التنبؤ بقيم مستمرة
يهدف الانحدار إلى التنبؤ بقيمة رقمية مستمرة. على سبيل المثال، تقدير سعر منزل بناءً على مساحته وموقعه وعدد غرفه. يتعلم النموذج رسم خط أو منحنى يقلل الفرق بين تنبؤاته والقيم الحقيقية. تشمل الخوارزميات الشائعة الانحدار الخطي أو الغابات العشوائية للعلاقات الأكثر تعقيدًا. الهدف هو تقليل الخطأ على قيم يمكن أن تكون أي عدد حقيقي.
التصنيف: تعيين الفئات
التصنيف، بدوره، يُسند تسمية منفصلة أو فئة. فكّر في اكتشاف ما إذا كان البريد الإلكتروني رسالة مزعجة أم لا، أو تحديد نوع زهرة من خلال قياسات بتلاتها. يتعلم النموذج فصل البيانات إلى فئات مميزة. غالبًا ما يُستخدم الانحدار اللوجستي، وأشجار القرار، أو الشبكات العصبية. وتكون المخرجات عادةً احتمالًا أو فئة محددة، مثل « رسالة مزعجة » أو « غير مزعجة ».
الفروق الرئيسية بين النهجين
يتمثل الاختلاف الرئيسي في طبيعة المتغير المستهدف: مستمر في حالة الانحدار، ومنفصل في حالة التصنيف. في الانحدار، يُقاس الخطأ بالمسافة الرقمية (مثل: فرق السعر)، بينما في التصنيف يتم تقييم معدل التنبؤات الصحيحة أو مصفوفة الالتباس. كما تختلف المقاييس أيضًا: RMSE للانحدار، والدقة أو الاستدعاء للتصنيف. وأخيرًا، غالبًا ما تتعامل مشاكل التصنيف مع اختلالات الفئات، بخلاف الانحدار.
أمثلة عملية واختيار الخوارزميات
لنتصور مشروع تنبؤ بالطقس: الانحدار لتقدير درجة الحرارة الدقيقة غدًا، والتصنيف لتحديد ما إذا كان سيمطر أم لا. حالة أخرى: التنبؤ بالدخل المستقبلي للعميل (انحدار) مقابل تحديد ما إذا كان سيُلغي اشتراكه (تصنيف). إليك مثال بسيط بلغة بايثون باستخدام scikit-learn:
from sklearn.linear_model import LinearRegression, LogisticRegression
# الانحدار: التنبؤ بسعر
model_reg = LinearRegression()
# التصنيف: التنبؤ بفئة
model_clf = LogisticRegression()
كيف تختار بين التصنيف والانحدار؟
راقب أولاً متغيرك المستهدف: هل هو عدد مستمر أم فئة؟ ثم اختبر توزيع البيانات والسؤال التجاري. إذا كنت تريد قيمة دقيقة مثل مبلغ، اختر الانحدار. أما للقرارات الثنائية أو متعددة الفئات، فالتصنيف مناسب. لا تتردد في تحويل المشكلة (على سبيل المثال، تجميع الأعمار في شرائح) للانتقال من نهج إلى آخر حسب احتياجاتك.
في الختام، التصنيف والانحدار متكاملان ويغطيان معظم حالات الاستخدام في التعلم الخاضع للإشراف. إتقان اختلافاتهما سيساعدك على تصميم حلول ذكاء اصطناعي أكثر ملاءمة وفعالية منذ مشاريعك الأولى.
💬 هل لديك سؤال أو ترغب في التعمق أكثر؟ انضم إلى المجتمع على ديسكورد: https://discord.gg/GwhUKccQcM